Exponat 33 · Robotermodelle · RT-1 und RT-2
Sprache wird zur Handlung
RT-1 und RT-2 verbinden gelernte Bildverarbeitung und sprachliche Aufgaben mit Roboteraktionen. Die Arbeiten von 2022 und 2023 zeigen Übertragung auf neue Situationen – innerhalb konkreter Körper, Daten und Bewegungsfähigkeiten.
4 Minuten Haupttext · Stand: 5. September 2026
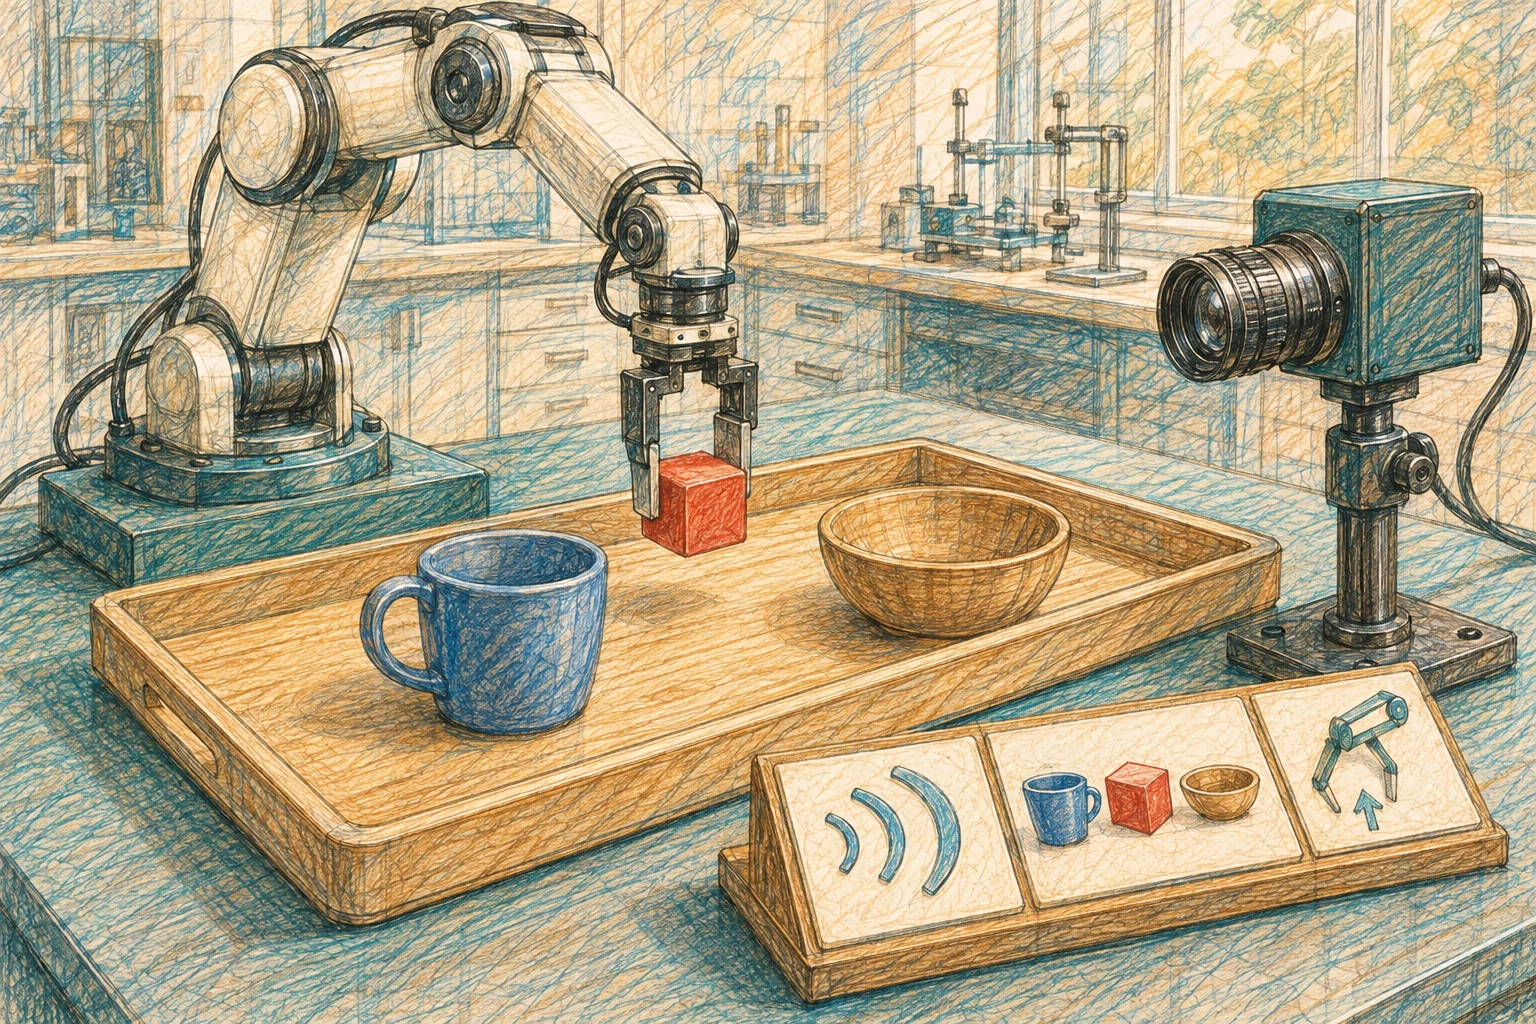 Bild vergrößern ↗
Auf einen Blick
Wie kann die Aufforderung, einen Gegenstand zu holen, zu einer Bewegung des Greifers werden?
- Roboteraktionen lassen sich als Ausgaben eines trainierten Modells darstellen.
- Sprachlich neue Aufgaben können bekannte Bewegungen anders kombinieren.
- Erfolgreiche Begriffsübertragung belegt keine beliebige neue Geschicklichkeit.
- Zeitliche Einordnung
- 2022: RT-1 · 2023: RT-2
- Orte und Regionen
- Internationale Forschung
- Historisch Beteiligte
- Anthony Brohan und die beteiligten Robotikteams bei Google und Google DeepMind
Die blaue Tasse bleibt ein körperlicher Gegenstand
„Lege die blaue Tasse in die Schale.“ Dieser eigens gewählte Museumsauftrag klingt überschaubar. Auf dem Tisch stehen aber mehrere Dinge, der Henkel kann anders ausgerichtet sein und der Greifer muss den Gegenstand erreichen. Eine passende sprachliche Antwort würde die Tasse noch nicht versetzen. Das Ergebnis muss im Raum eintreten.
An diesem Beispiel lassen sich mehrere Fragen auseinanderhalten. Welcher Gegenstand ist gemeint? Welche Bewegung passt zu ihm? Was hat der Arm nach der Bewegung tatsächlich erreicht? Unser Exponat untersucht Verfahren, die solche Aufgaben mit gelernten Modellen verbinden. Es zeigt weder einen fertigen Universalhelfer noch eine Geschichte, in der das Anbringen eines Sprachmodells allein sämtliche körperlichen Probleme löst.
RT-1 erhält Beispiele aus der Roboterpraxis
Die RT-1-Arbeit von 2022 beschreibt rund 130.000 Vorführungen, gesammelt mit 13 Robotern über 17 Monate. Menschen steuerten die Roboter für die Datenerhebung. Als Aufgaben zählt die Studie sprachliche Anweisungen mit Tätigkeiten und Gegenständen; die Zahl 744 bezeichnet daher nicht 744 grundsätzlich unabhängige Bewegungsarten. Daten und Aufgabenzählung in RT-1
Für unser Tassenbeispiel ist dieser Unterschied leicht zu verstehen. „Nimm die rote Dose“ und „Nimm die blaue Tasse“ können getrennte Anweisungen sein, obwohl beide einen Greifablauf verlangen. Welche Unterschiede ein Modell dabei tatsächlich bewältigt, lässt sich erst mit geeigneten Versuchen feststellen. Die Anzahl der Namen auf einer Aufgabenliste ist dafür allein kein ausreichender Maßstab.
RT-2 verbindet Bild-Sprache-Training mit Aktionen
RT-2 baut 2023 auf vortrainierten Bild-Sprach-Modellen auf und trainiert sie gemeinsam mit Robotertrajektorien sowie weiteren Bild-Sprach-Daten nach. Die Ausgaben repräsentieren auch Roboteraktionen: Änderungen der Greiferposition und Orientierung, die Greiferöffnung und das Ende einer Episode werden als diskrete Zeichen dargestellt. Die Aktionsdarstellung von RT-2
In der Zeichnung stehen die Kacheln für diese Übersetzung zwischen Darstellungen. Sie zeigen keine reale Befehlsfolge. Der wichtige Gedanke ist, dass eine Folge von Modellwerten verschiedene Rollen annehmen kann. Im einen Zusammenhang wird daraus lesbarer Text; im anderen wird sie durch eine festgelegte Schnittstelle als Aktionsvorgabe verarbeitet. Der mechanische Arm bleibt dabei ein eigener Teil des Systems.
Ein neuer Begriff kann auf eine bekannte Bewegung treffen
Stell dir vor, unser Roboter hat bereits Tassen gegriffen, kennt aber die Formulierung „das Trinkgefäß“ aus keiner seiner bisherigen Roboteraufgaben. Würde er damit dieselbe Tasse richtig auswählen, wäre das eine interessante Übertragung. Sie wäre etwas anderes als erstmals einen verknoteten Beutel zu öffnen. Das zweite Problem verlangt möglicherweise Bewegungen, die in seinen Beispielen überhaupt nicht vorkamen.
Die RT-2-Autoren benennen diese Grenze ausdrücklich: Zusätzliches Bild-Sprach-Vortraining erweitert semantische und visuelle Übertragung, verleiht dem Roboter aber nicht automatisch neue motorische Fertigkeiten außerhalb seiner Roboterdaten. Die erläuterte Grenze der Übertragung Das eigene Tassenbeispiel veranschaulicht diese Unterscheidung; es ist kein nachträglich erfundener Messwert der Studie.
Was bei einem Vergleich gleich bleiben muss
Für einen fairen Museumsversuch würden wir festhalten, welche Tassen verwendet wurden, wie sie lagen und wann eine Aufgabe als beendet gilt. Anschließend könnten wir gezielt nur eine Sache verändern: etwa die Formulierung oder die Position. Wenn dagegen zugleich Beleuchtung, Greifer, Gegenstand und Ziel wechseln, wäre ein Misserfolg schwerer einer einzelnen Ursache zuzuordnen.
RT-1 unterscheidet bei seiner Auswertung unter anderem bekannte und neue Aufgaben sowie veränderte Hintergründe und Ablenkungen. Seine Modellkarte begrenzt die Eignung auf den untersuchten Forschungskontext. Prüfkriterien und Modellkarte Das ist ein nützlicher Maßstab für die Lektüre späterer Meldungen: Die Art der Neuheit gehört zur Leistungsangabe dazu.
Auch ein klar klingender Satz braucht Auslegung
Bleiben wir beim erfundenen Auftrag. Darf die Tasse am Rand der Schale stehen? Soll sie leer sein? Was passiert, wenn zwei blaue Tassen auf dem Tisch stehen? Diese Fragen sind im Satz nicht vollständig beantwortet. Eine Vorführung kann stillschweigend viele davon festlegen, weil Menschen die Umgebung bereits passend vorbereitet haben.
Für Besucher ist deshalb auch das Unsichtbare interessant: Wer wählt die Gegenstände aus, wer formuliert die Anweisung und wer entscheidet über Erfolg? Das schmälert eine gezeigte Verbesserung nicht. Es macht verständlich, worin sie besteht. Eine aussagekräftige Demonstration zeigt ein klar eingegrenztes Können und ermöglicht, die Bedingungen dieses Könnens wiederzuerkennen.
Sprache ist ein Zugang zu einer größeren Funktionskette
Du kannst von hier in zwei Richtungen weitergehen. Das Exponat zum Vormachen fragt, wie aus beobachteten Bewegungsfolgen eine Handlungsweise gelernt wird. Die Laborstation fragt dagegen, wie ausgeführte Handlungen neue Messungen liefern. Beide ergänzen die Frage nach der sprachlichen Aufgabe.
Beim Rückblick auf den Tisch genügt eine einfache Prüfung: Ist nur die Anweisung neu, der ausgewählte Gegenstand, die Umgebung oder die erforderliche Bewegung? Wenn du diese Möglichkeiten getrennt benennen kannst, hast du einen wesentlichen Unterschied zwischen einer eindrucksvollen Vorführung und einer präzise beschriebenen Übertragungsleistung verstanden.
Grenzen des Wissens
Was offen bleibt
Die Zeichnung ist ein konzeptionelles Anschauungsbild, kein Originalgerät oder Messprotokoll. Historische Resultate werden im Text mit ihrem Versuchsrahmen und ihren Grenzen erläutert.
Begriffe verstehen
VLA-Modell
Vision-Language-Action-Modell: verbindet Bild-, Sprach- und Aktionsverarbeitung.
Generalisierung
Leistung bei Situationen, die sich von den Trainingsbeispielen unterscheiden; der Unterschied muss konkret benannt werden.
Endeffektor
Werkzeug am Ende eines Roboterarms, beispielsweise ein Greifer.
Teleoperation
Steuern eines Roboters durch einen Menschen über eine technische Bedienverbindung.
Quellen und Nachweise
Die Quellen sind den Aussagen im Text zugeordnet. Originalstudien, Sammlungstexte und eigene Einordnung erfüllen unterschiedliche Aufgaben. Einige Fachtexte sind beim Verlag nur teilweise frei zugänglich.
- RT-1: Lernen aus vielen Robotervorführungen
Brohan, A. et al. (2022): RT-1: Robotics Transformer for Real-World Control at Scale. arXiv:2212.06817.
744 sprachlich definierte Aufgabenvarianten sind keine 744 grundsätzlich verschiedenen motorischen Fähigkeiten.
← Zur Textstelle 1: RT-1 erhält Beispiele aus der Roboterpraxis← Zur Textstelle 2: Was bei einem Vergleich gleich bleiben muss - RT-2: Bild, Sprache und Roboteraktion
Brohan, A. et al. (2023): RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. arXiv:2307.15818.
Semantische Übertragung erweitert die im Roboterdatensatz enthaltenen Bewegungsfähigkeiten nicht beliebig.
← Zur Textstelle 1: RT-2 verbindet Bild-Sprache-Training mit Aktionen← Zur Textstelle 2: Ein neuer Begriff kann auf eine bekannte Bewegung treffen
Redaktion: Benjamin Metzig. Erste vollständige Fassung. Recherche- und Bearbeitungsstand: 5. September 2026. Generative KI diente als Werkzeug für Text und Bild.
Hinweis oder Korrektur an die RedaktionZusammenhänge entdecken
Exponat · Modellarchitektur · Transformer
Aufmerksamkeit verbindet
Wie kann ein Modell weit auseinanderliegende Teile einer Eingabe miteinander in Beziehung setzen?
Exponat erkunden ↗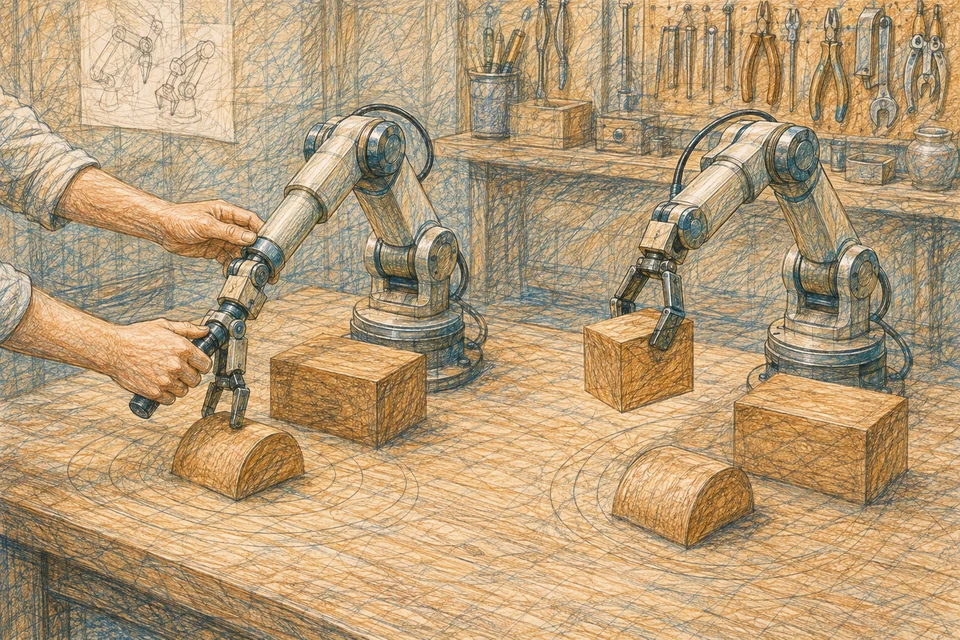
Exponat · Handlungslernen · Diffusion Policy
Roboter lernen durch Vormachen
Wie lernt ein Roboter einen brauchbaren Ablauf, wenn mehrere Wege zum Ziel führen?
Exponat erkunden ↗
Exponat · Orientierung · SLAM
Roboter finden ihren Weg
Wie entsteht eine Karte, wenn ein Roboter seinen eigenen Standort noch nicht genau kennt?
Exponat erkunden ↗