Exponat 34 · Handlungslernen · Diffusion Policy
Roboter lernen durch Vormachen
Beim Lernen durch Vormachen liefern Demonstrationen Beispiele für Handlungen. Diffusion Policy verbindet dieses Prinzip 2023 mit generativer Modellierung von Aktionsfolgen und fortlaufender Rückmeldung aus der Umgebung.
4 Minuten Haupttext · Stand: 5. September 2026
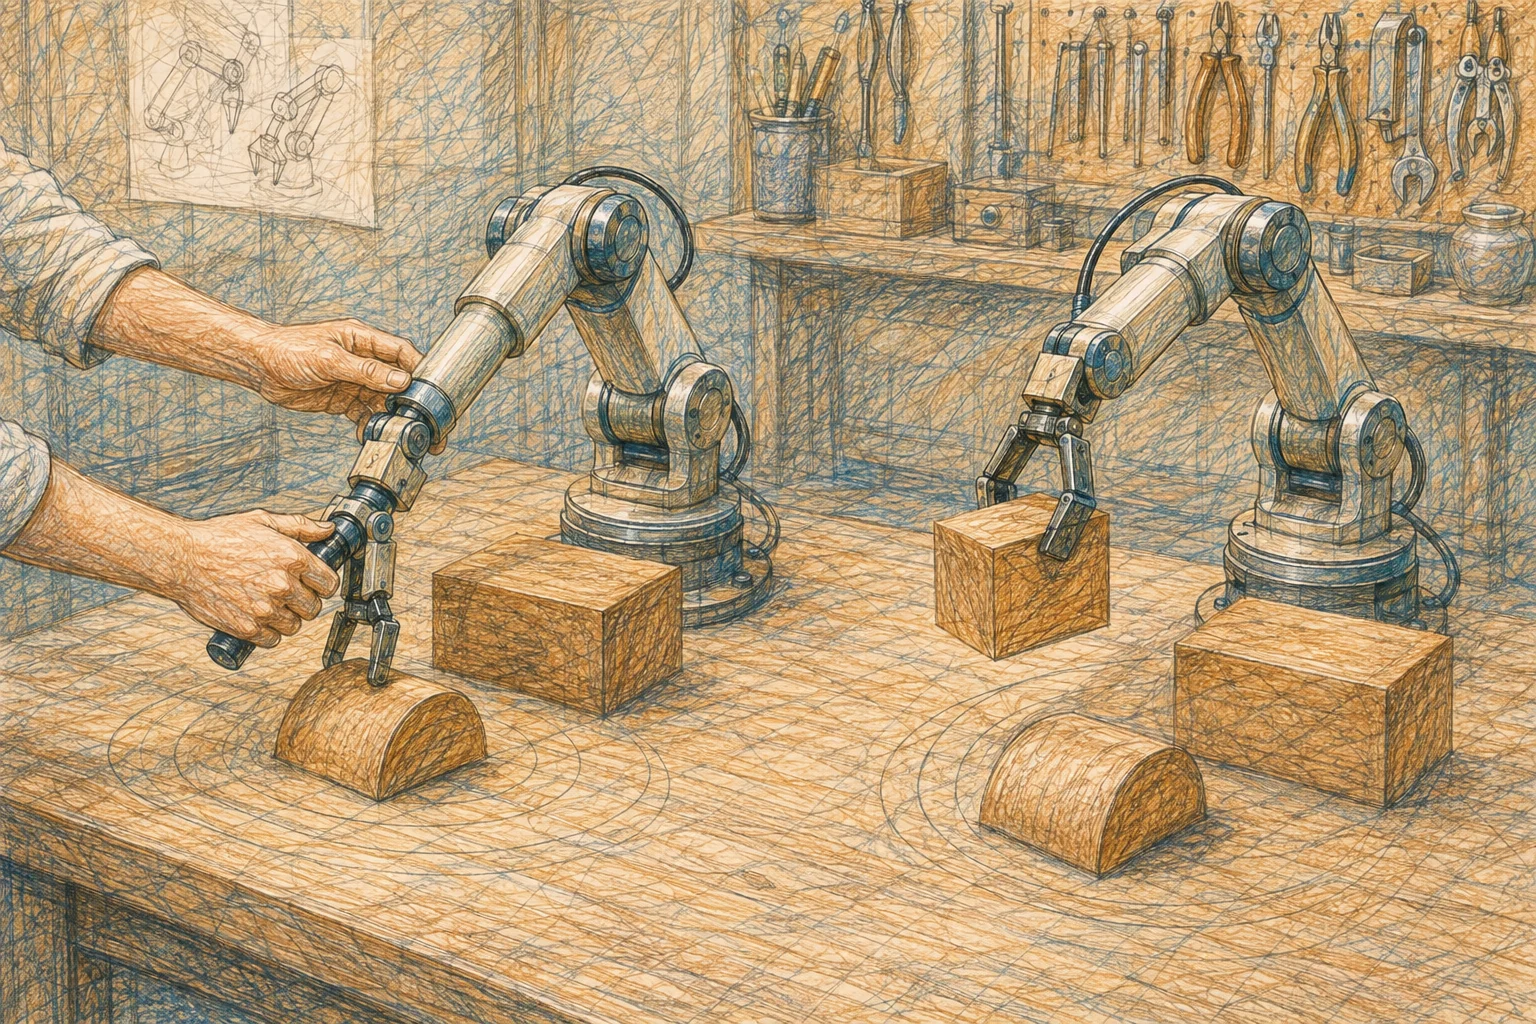 Bild vergrößern ↗
Auf einen Blick
Wie lernt ein Roboter einen brauchbaren Ablauf, wenn mehrere Wege zum Ziel führen?
- Eine Demonstration verbindet Beobachtungen mit ausgeführten Handlungen.
- Mehrere gute Wege sollten nicht zu einem schlechten Mittelweg vermischt werden.
- Ein vorausberechneter Ablauf muss mit neuen Beobachtungen vereinbar bleiben.
- Zeitliche Einordnung
- Ältere Demonstrationsverfahren · 2023: Diffusion Policy · 2024: erweiterte Studie
- Orte und Regionen
- Internationale Forschung
- Historisch Beteiligte
- Cheng Chi, Shuran Song und das beteiligte Forschungsteam
Ein Hindernis macht den Durchschnitt unbrauchbar
Ein Holzblock soll auf die andere Tischseite gelangen. In unserem erfundenen Beispiel steht in der Mitte ein hohes Hindernis. Eine Person führt den Greifer links daran vorbei, eine andere rechts. Beide Vorführungen erfüllen den Auftrag. Eine Bewegung genau zwischen den beiden Wegen könnte dagegen geradewegs gegen das Hindernis führen.
Das Gedankenbild erklärt, weshalb Lernen aus mehreren Beispielen mehr verlangen kann als das Mitteln ihrer Bewegungen. Die Unterschiede enthalten möglicherweise mehrere sinnvolle Lösungen. Das Modell soll eine davon brauchbar ausführen können. Die Illustration stellt diese Frage räumlich dar, ohne echte Messkurven oder den genauen Aufbau einer veröffentlichten Versuchsanordnung vorzugeben.
Was eine Demonstration enthält
Russ Tedrake beschreibt Imitationslernen in seinen MIT-Kursnotizen als Lernen aus Zustands- oder Beobachtungsfolgen und den zugehörigen Aktionen. Beim Behavior Cloning wird daraus unmittelbar eine Policy gelernt. Ein ausdrücklich vorgegebenes Belohnungsmaß ist dafür nicht zwingend nötig; die Beispiele liefern das Verhalten, an dem sich das Training ausrichtet. Die Grundlagen des Imitationslernens
Auf unserem Tisch wäre daher nicht nur der Endpunkt interessant. Zu einem Zeitpunkt sieht der Greifer den Block noch vor dem Hindernis, später daneben. Welche Handlung zu welchem Eindruck gehört, hilft den Ablauf zu beschreiben. Die Wahl der Beobachtungen gehört zum Entwurf: Was eine Kamera nicht zeigt, kann aus genau diesem Bild auch nicht direkt abgelesen werden.
Generative Modellierung von Handlungen
Diffusion Policy stellt 2023 eine Policy als bedingten Entrauschungsprozess dar. Das Modell erzeugt Aktionsfolgen anhand der verfügbaren Beobachtungen. Die Methode kann mehrere mögliche Handlungsverläufe repräsentieren, statt nur eine einzelne Ausgabeform vorzusehen. Die erweiterte Veröffentlichung von 2024 untersucht zusätzliche Aufgaben und Modellentscheidungen. Das Verfahren und seine beiden Publikationsstände
Der Bezug zur Bilderzeugung ist strukturell: Ein generatives Verfahren erzeugt hier Handlungswerte. Es muss keine zukünftige Fotografie des Tisches malen. Diese Unterscheidung hilft, den Begriff Diffusion nicht mit einem bestimmten Bildstil zu verwechseln. Im benachbarten Raum geht es um Bildausgaben, hier um Werte, die als Vorgaben für einen Roboter genutzt werden.
Eine Folge vorhersagen, einen Teil ausführen
Die untersuchte Methode verbindet Aktionsfolgen mit wiederholter Neuplanung. Zunächst wird ein Abschnitt ausgeführt, dann gehen aktuelle Beobachtungen in die nächste Vorhersage ein. Zu lange Ausführungsabschnitte können die Reaktion auf Veränderungen erschweren; zusätzliche Berechnungen brauchen wiederum Zeit. Auch unzureichende Demonstrationsdaten bleiben eine Grenze. Rückkopplung, Rechenzeit und Grenzen
Unser Holzblock kann beim Ablegen etwas verrutschen. Eine reine Wiederholung der ursprünglichen Vorführung würde noch von seiner alten Lage ausgehen. Eine neue Beobachtung eröffnet die Möglichkeit, den weiteren Ablauf an die tatsächliche Situation anzupassen. Das ist eine eigene Erklärung des Rückkopplungsprinzips, keine Behauptung, dass jede Störung damit bereits erfolgreich bewältigt sei.
Ein T-förmiger Block ist eine definierte Aufgabe
Die Projektseite zeigt unter anderem Push-T: Ein T-förmiges Objekt wird in eine Zielregion geschoben, anschließend bewegt sich das Werkzeug in eine Endzone. Weitere Vorführungen betreffen das Wenden einer Tasse sowie das Ausschöpfen und Verteilen von Sauce. Das sind unterschiedliche konkrete Aufgaben mit benennbaren Endbedingungen. Die originalen Versuchsbeispiele
Für unser Museumsbeispiel könnten wir ähnlich festlegen, wo der Holzblock am Schluss liegen und ob das Hindernis unberührt bleiben soll. Erst diese Festlegung macht einen Vergleich verständlich. Ein schön aussehender Bewegungsbogen wäre dann kein Erfolgskriterium für sich. Ein weniger eleganter Weg könnte den Auftrag besser erfüllen, wenn er das Ziel unter den festgelegten Bedingungen zuverlässig erreicht.
Auch beim Vormachen werden Entscheidungen getroffen
Welche Beispiele würden wir für unseren Tisch sammeln? Nur gelungene Abläufe bei gleicher Beleuchtung oder auch verschiedene Ausgangslagen? Würden linke und rechte Umgehungen gleich häufig vorkommen? Das sind offene Entwurfsfragen für das Gedankenexperiment. Schon bevor ein Modell trainiert wird, entsteht durch diese Auswahl eine bestimmte Sammlung von Erfahrungen.
Der Lernprozess ist deshalb nicht allein an der späteren Bewegung abzulesen. Die Arbeitszeit hinter den Vorführungen und die Gestaltung der Aufgaben gehören ebenfalls zur Geschichte. Das Exponat macht diese menschlichen Beiträge sichtbar, ohne aus einer Zeichnung abzuleiten, mit welcher konkreten Bedienvorrichtung sämtliche Originaldaten erhoben wurden. Unterschiedliche Studien und Aufgaben nutzen unterschiedliche Formen des Vormachens.
Welche Veränderung würdest du zuerst testen?
Verschiebe gedanklich nur das Hindernis. Die Aufgabe bleibt gleich, doch der bisher gute linke Weg ist nun versperrt. Was müsste die Kamera erfassen, und welcher Teil der Bewegung wäre anzupassen? Stelle anschließend den alten Aufbau wieder her und verändere nur das Ziel. So trennst du zwei verschiedene Anforderungen an einen gelernten Ablauf.
Mit dieser Unterscheidung führt der Rundgang ins Labor weiter. Dort zählt ebenfalls nicht bloß eine eindrucksvolle Bewegung. Die Handlung soll einen brauchbaren Versuch ermöglichen, dessen Ergebnis die nächste Entscheidung beeinflusst. Das macht den Übergang von der einzelnen Fertigkeit zur automatisierten Forschung anschaulich.
Grenzen des Wissens
Was offen bleibt
Die Zeichnung ist ein konzeptionelles Anschauungsbild, kein Originalgerät oder Messprotokoll. Historische Resultate werden im Text mit ihrem Versuchsrahmen und ihren Grenzen erläutert.
Begriffe verstehen
Policy
Eine Regel oder ein Modell, das aus verfügbaren Beobachtungen Handlungen bestimmt.
← Zur TextstelleRückkopplung
Neue Beobachtungen des erreichten Zustands beeinflussen die folgenden Handlungen.
Quellen und Nachweise
Die Quellen sind den Aussagen im Text zugeordnet. Originalstudien, Sammlungstexte und eigene Einordnung erfüllen unterschiedliche Aufgaben. Einige Fachtexte sind beim Verlag nur teilweise frei zugänglich.
- Diffusion Policy: Original und erweiterte Untersuchung
Chi, C. et al. (2023/2024): Diffusion Policy: Visuomotor Policy Learning via Action Diffusion. RSS 2023; erweiterte IJRR-Fassung 2024, arXiv:2303.04137v5.
RSS-/Projektfassung: 12 Benchmarkaufgaben; erweiterte Fassung: 15. Versionsstände getrennt behandeln.
← Zur Textstelle 1: Generative Modellierung von Handlungen← Zur Textstelle 2: Eine Folge vorhersagen, einen Teil ausführen - Versuchsbeispiele und Daten zu Diffusion Policy
Chi, C. und Mitwirkende: Diffusion Policy, offizielle Projektseite.
Videos illustrieren einzelne Abläufe; Leistungsurteile benötigen die publizierten Vergleiche.
← Zur Textstelle: Ein T-förmiger Block ist eine definierte Aufgabe - Was Lernen durch Vormachen bedeutet
Tedrake, R. (2024): Underactuated Robotics, Kapitel Imitation Learning. MIT-Kursnotizen.
Arbeitsnotizen mit ausdrücklich unfertigen Passagen; verwendet werden die ausgeführten Grundlagen, keine Platzhalter oder unbelegten Rekordurteile.
← Zur Textstelle: Was eine Demonstration enthält
Redaktion: Benjamin Metzig. Erste vollständige Fassung. Recherche- und Bearbeitungsstand: 5. September 2026. Generative KI diente als Werkzeug für Text und Bild.
Hinweis oder Korrektur an die RedaktionZusammenhänge entdecken
Exponat · Generatives Verfahren · Diffusionsmodelle
Bilder aus Rauschen
Wie kann eine Folge kleiner Entrauschungsschritte ein neues Bild hervorbringen?
Exponat erkunden ↗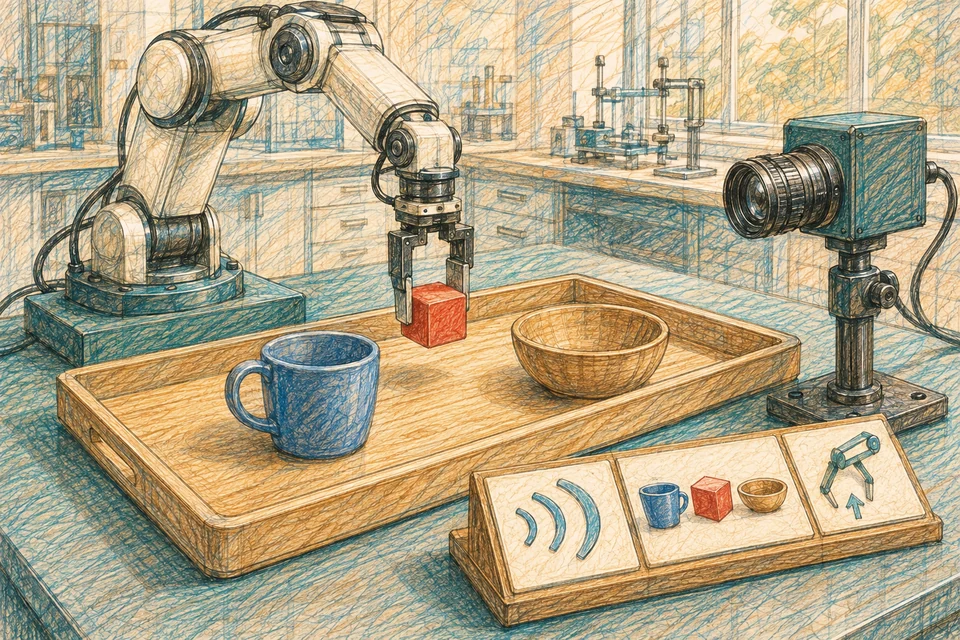
Exponat · Robotermodelle · RT-1 und RT-2
Sprache wird zur Handlung
Wie kann die Aufforderung, einen Gegenstand zu holen, zu einer Bewegung des Greifers werden?
Exponat erkunden ↗
Exponat · Automatisierte Wissenschaft · Hefeforschung
Adam prüft Hypothesen
Was muss ein Laborroboter zusätzlich können, damit aus Messungen eine geprüfte Vermutung wird?
Exponat erkunden ↗