Exponat 27 · Modellarchitektur · Transformer
Aufmerksamkeit verbindet
Der Transformer machte 2017 Aufmerksamkeit zum zentralen Verbindungsprinzip einer erfolgreichen Übersetzungsarchitektur. Sein Name bezeichnet eine Rechenweise; die menschliche Bedeutung von Aufmerksamkeit erklärt sie nur begrenzt.
4 Minuten Haupttext · Stand: 5. September 2026
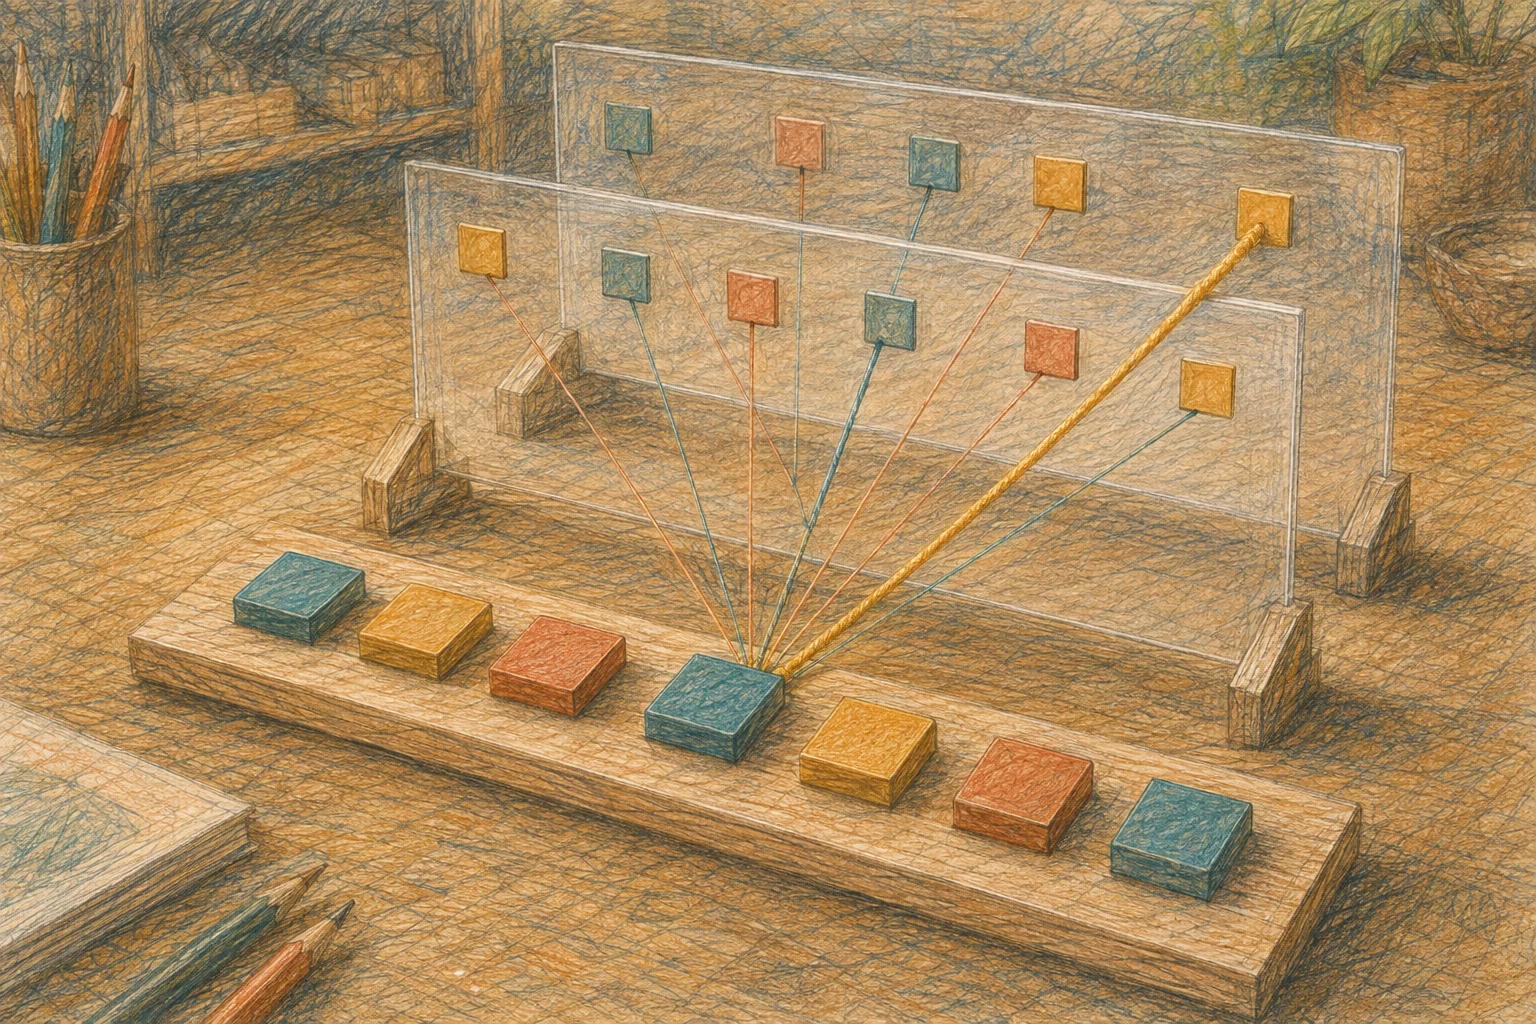 Bild vergrößern ↗
Auf einen Blick
Wie kann ein Modell weit auseinanderliegende Teile einer Eingabe miteinander in Beziehung setzen?
- Attention berechnet gewichtete Beziehungen zwischen Zahlenrepräsentationen.
- Der Transformer verbindet mehrere solche Berechnungen mit weiteren Verarbeitungsschritten.
- Ein hoher Attention-Wert ist keine vollständige Erklärung einer Modellentscheidung.
- Zeitliche Einordnung
- 2014/2015: Attention in Übersetzung · 2017: Transformer
- Orte und Regionen
- Internationale Forschung; Google und Universitäten
- Historisch Beteiligte
- Dzmitry Bahdanau, Kyunghyun Cho, Yoshua Bengio; Ashish Vaswani und das Transformer-Team
Die gleiche Kachel, ein anderer Zusammenhang
Ein Wort steht selten allein. In „Die Lampe steht neben der Schale, weil sie dort besser leuchtet“ hilft dir der restliche Satz, den Bezug von „sie“ zu bestimmen. Dieses eigens formulierte Beispiel zeigt eine Aufgabe: Eine Stelle soll Informationen aus anderen Stellen berücksichtigen. Ein reines Nachschlagen des einzelnen Wortes reicht dafür nicht aus.
Die Holzkacheln im Bild stehen für verarbeitete Einheiten. Ihre Fäden verlaufen nicht nur zur unmittelbar nächsten Kachel. Ein längerer Abstand muss deshalb keine lange Kette von Nachbarbeziehungen bedeuten. Das Modell dieser Verbindung ist eine anschauliche Einladung. Es wäre zu viel daraus abzuleiten, ein tatsächlich trainiertes Netz würde genau unser grammatisches Argument bilden.
Aufmerksamkeit begann vor dem Transformer
Bahdanau, Cho und Bengio schlugen bereits im 2014 veröffentlichten Preprint und auf der ICLR 2015 eine wichtige Veränderung neuronaler Übersetzung vor. Statt einen ganzen Ausgangssatz nur in eine feste Zusammenfassung zu pressen, sollte das System beim Erzeugen eines Zielworts unterschiedliche Teile des Ausgangssatzes gewichten können. Die Zuordnung wurde mitgelernt. Die frühe Arbeit zu Attention in Übersetzung
Der historische Unterschied ist wichtig: Attention ist ein allgemeineres Prinzip als Transformer. Eine erfolgreiche spätere Architektur kann eine vorhandene Idee neu organisieren und dadurch eine andere Reichweite gewinnen. Die Entdeckungsgeschichte besteht hier aus mehreren Schritten, mit verschiedenen Beiträgen und Fragestellungen.
Was bei Attention miteinander verrechnet wird
Die Transformer-Veröffentlichung beschreibt Query, Key und Value als Zahlenvektoren. Aus dem Vergleich einer Query mit Keys entstehen Gewichte. Mit ihnen werden Values zu einer neuen Darstellung zusammengeführt. Mehrere Attention-Köpfe arbeiten mit unterschiedlich gelernten Projektionen. Das schafft mehrere Wege, Informationen aus einer Folge zu kombinieren. Die Architektur von 2017
Du kannst das Gewichtungsprinzip mit drei transparenten Farbkarten selbst gedanklich nachvollziehen. Legst du jede gleich stark über eine Fläche, entsteht eine Mischung. Verstärkst du eine Karte und schwächst die anderen, verändert sich die Mischung. Das sind keine tatsächlichen Tokenvektoren, aber die Unterscheidung wird sichtbar: Informationen zu kombinieren ist etwas anderes, als genau einen Gegenstand auszuwählen und alles andere zu vergessen.
Eine kleine eigene Rechnung
Nimm als vereinfachtes Anschauungsbeispiel drei Werte: 2, 4 und 10. Mit Gewichten von 0,5, 0,25 und 0,25 ergibt ihre gewichtete Summe 4,5. Mit 0,1, 0,1 und 0,8 wird daraus 8,6. Die verfügbaren Werte sind gleich geblieben; geändert hat sich ihr Einfluss. Echte Attention-Operationen verwenden Vektoren und gelernte Abbildungen, unser Beispiel nur einzelne Zahlen.
Die Rechnung erklärt noch nicht, woher sinnvolle Gewichte kommen. Ebenso wenig sagt die Zahl 8,6 etwas über die Bedeutung einer Aussage. Diese zweite Ebene wird leicht übersehen, wenn eine farbige Verbindungsgrafik schon wie eine Erklärung wirkt. Das Rechenprinzip, seine gelernten Einstellungen und die sprachliche Deutung müssen jeweils für sich betrachtet werden.
Wie daraus ein Transformer wird
Der ursprüngliche Transformer verbindet Attention mit weiteren Netzschritten und Positionsinformationen. Sein Übersetzungsmodell besitzt einen Encoder und einen Decoder. Im Decoder verhindert eine Maske, dass die Vorhersage auf noch nicht verfügbare spätere Ausgabeelemente zugreift. Die Arbeit untersucht unter anderem Übersetzung zwischen Englisch und Deutsch sowie Englisch und Französisch. Aufbau und Übersetzungsversuche
Die verbesserte Parallelisierbarkeit betrifft insbesondere die Verarbeitung beim Training. Daraus folgt nicht, dass ein autoregressives Modell beim Antworten alle Wörter unabhängig gleichzeitig ausgibt. Dieser Unterschied hilft, zwei Beobachtungen zusammenzubringen: Viele Berechnungen können parallel stattfinden, während eine erzeugte Folge weiterhin von ihren bereits ausgegebenen Teilen abhängt.
Ein Fadendiagramm ist noch kein Beweis
Welche Eingaben waren für eine Antwort entscheidend? Diese Frage ist anspruchsvoller als das Anzeigen einiger Gewichte. Jain und Wallace untersuchten 2019 Aufmerksamkeitsmodelle in Sprachaufgaben. Unter anderem fanden sie sehr unterschiedliche Attention-Verteilungen, die ähnliche Vorhersagen hervorbrachten. Die einfache Gleichsetzung von großem Gewicht und vollständiger Erklärung hält solchen Prüfungen nicht allgemein stand. Die Untersuchung zur Erklärbarkeit
Für unser Anschauungsmodell heißt das: Ein kräftiger Faden zeigt eine gewichtete Verbindung, nicht den ganzen Weg zur Ausgabe. Er macht das übrige System nicht überflüssig. Wer eine Entscheidung erklären will, braucht zusätzlich eine präzise Frage und geeignete Vergleichs- oder Eingriffsversuche. Auch eine visuell überzeugende Darstellung muss sich daran messen lassen.
Architektur und Verhalten sind verschiedene Aufgaben
Ein Bauplan legt fest, welche Rechenoperationen miteinander verbunden werden können. Er bestimmt für sich allein noch nicht, welche Beispiele ein System gesehen hat, welche Ziele beim Training verfolgt wurden oder wie eine spätere Anwendung seine Ausgaben auswählt. Deshalb können Modelle mit verwandten Grundbausteinen unterschiedliche Fähigkeiten und Schwächen zeigen.
Im Museum führt von hier ein Weg zur Bilderzeugung und ein weiterer zur Bewertung von Antworten. Beide Stationen helfen, die Ebenen auseinanderzuhalten. Es ist sinnvoll, nach dem konkreten Modell und seiner Prüfung zu fragen, statt aus dem Wort Transformer schon ein umfassendes Urteil über Verstehen, Zuverlässigkeit oder Bewusstsein abzuleiten.
Grenzen des Wissens
Was offen bleibt
Das gezeichnete Fadennetz ist eine didaktische Analogie. Es zeigt weder tatsächliche Gewichte eines Sprachmodells noch dessen Gedanken. Befunde einzelner Architektur- und Erklärungsstudien gelten unter ihren jeweiligen Bedingungen.
Begriffe verstehen
Token
Eine verarbeitete Einheit einer Eingabe, etwa ein Wortteil oder ein Bildausschnitt; sie wird als Zahlenrepräsentation weitergegeben.
Self-Attention
Berechnung von Beziehungen zwischen Positionen derselben Eingabefolge.
Query
Eine gelernte Zahlenrepräsentation, die beim Attention-Vergleich mit den Keys anderer Positionen kombiniert wird.
← Zur TextstelleKey
Eine Zahlenrepräsentation, die für die Berechnung eines Attention-Gewichts mit einer Query verglichen wird.
← Zur TextstelleValue
Der Informationsvektor, der mit dem berechneten Gewicht in die Ausgabe einer Attention-Operation eingeht.
← Zur TextstelleQuellen und Nachweise
Die Quellen sind den Aussagen im Text zugeordnet. Originalstudien, Sammlungstexte und eigene Einordnung erfüllen unterschiedliche Aufgaben. Einige Fachtexte sind beim Verlag nur teilweise frei zugänglich.
- Aufmerksamkeit vor dem Transformer
Bahdanau, D., Cho, K. und Bengio, Y. (2015): Neural Machine Translation by Jointly Learning to Align and Translate. ICLR 2015; Preprint 2014. arXiv:1409.0473.
Dynamische weiche Zuordnung zu Teilen des Ausgangssatzes; Attention wurde nicht erst 2017 erfunden.
← Zur Textstelle: Aufmerksamkeit begann vor dem Transformer - Die Transformer-Architektur
Vaswani, A. et al. (2017): Attention Is All You Need. Advances in Neural Information Processing Systems 30. arXiv:1706.03762.
Query, Key, Value, mehrere Köpfe, Positionen und maskierte Decoder-Selbstaufmerksamkeit. Parallelisierung beim Training nicht mit gleichzeitiger Ausgabe aller Tokens verwechseln.
← Zur Textstelle 1: Was bei Attention miteinander verrechnet wird← Zur Textstelle 2: Wie daraus ein Transformer wird - Attention-Gewichte erklären nicht automatisch eine Entscheidung
Jain, S. und Wallace, B. C. (2019): Attention is not Explanation. NAACL 2019. arXiv:1902.10186.
Untersuchte NLP-Modelle zeigen verschiedene Attention-Verteilungen bei ähnlichen Vorhersagen; Befund begrenzt die einfache Lesart als Erklärung.
← Zur Textstelle: Ein Fadendiagramm ist noch kein Beweis
Redaktion: Benjamin Metzig. Erste vollständige Fassung. Recherche- und Bearbeitungsstand: 5. September 2026. Generative KI diente als Werkzeug für Text und Bild.
Hinweis oder Korrektur an die RedaktionZusammenhänge entdecken
Exponat · Lernverfahren · Bildklassifikation
Bildnetze lernen Merkmale
Wie lernt ein Rechner, Bilder zu unterscheiden, ohne dass jemand jede Form einzeln programmiert?
Exponat erkunden ↗
Exponat · Generatives Verfahren · Diffusionsmodelle
Bilder aus Rauschen
Wie kann eine Folge kleiner Entrauschungsschritte ein neues Bild hervorbringen?
Exponat erkunden ↗
Exponat · Nachtraining · Lernen aus Präferenzen
Menschen bewerten Antworten
Wie lässt sich ein Modell an hilfreichen Antworten ausrichten, wenn es keine einzige richtige Formulierung gibt?
Exponat erkunden ↗