Exponat 28 · Generatives Verfahren · Diffusionsmodelle
Bilder aus Rauschen
Diffusionsmodelle lernen, gestörte Daten schrittweise in plausible Strukturen zu überführen. Von der frühen Idee 2015 über DDPM 2020 bis zur latenten Diffusion führt der Weg zu leistungsfähiger Bilderzeugung und neuen Fragen nach Trainingsdaten.
4 Minuten Haupttext · Stand: 5. September 2026
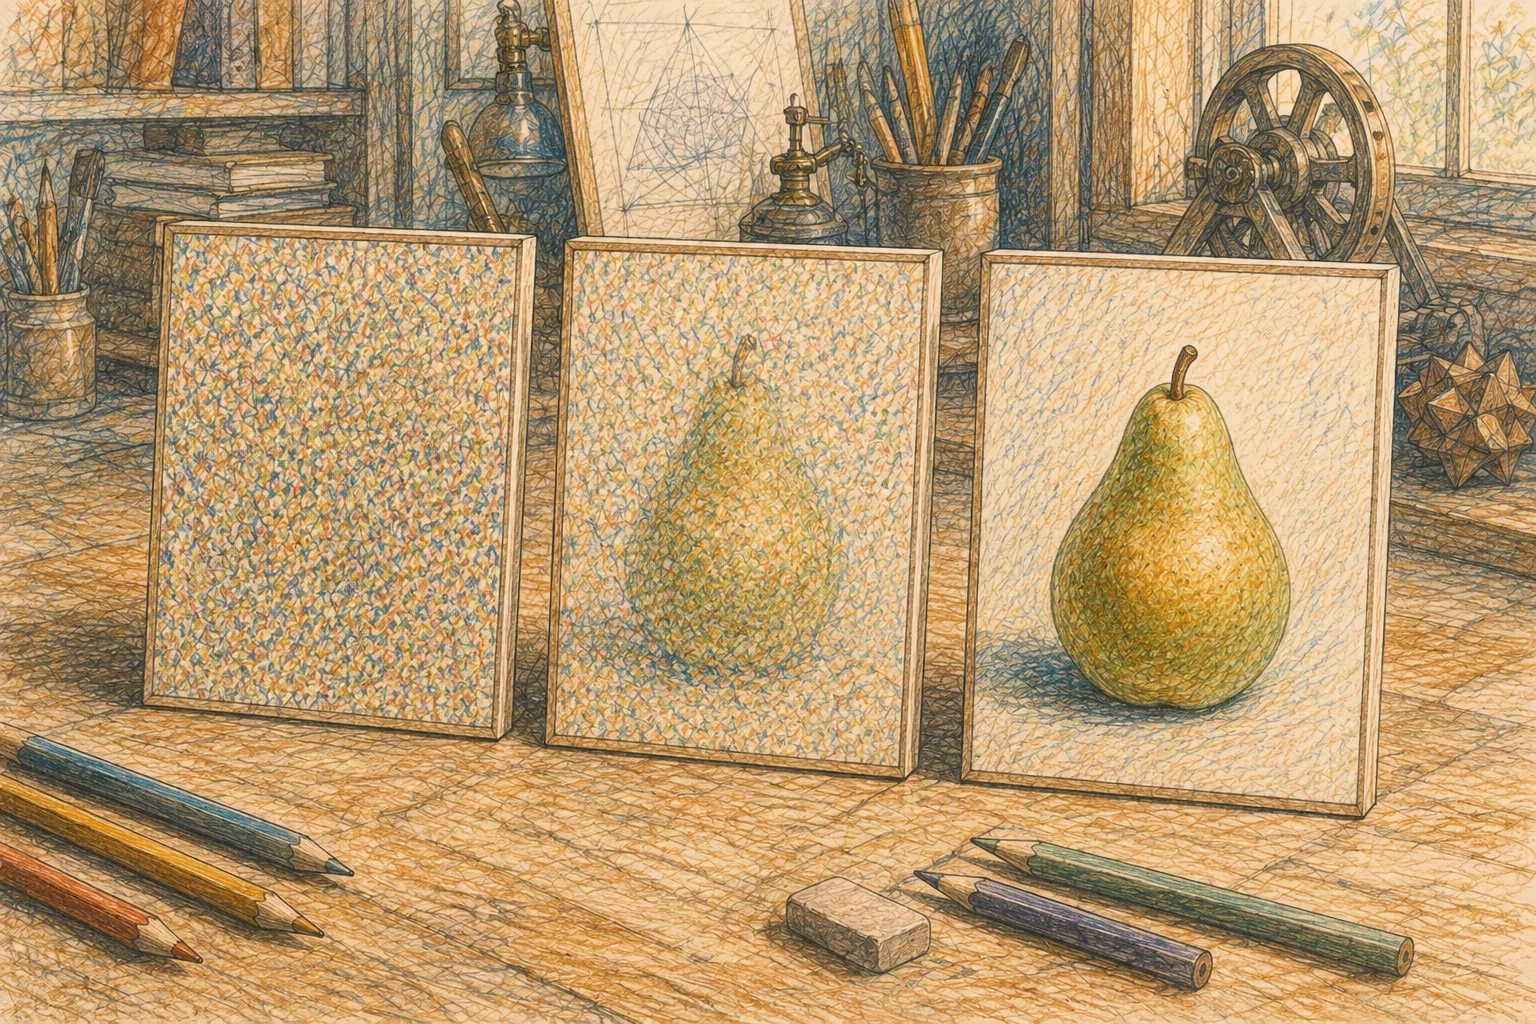 Bild vergrößern ↗
Auf einen Blick
Wie kann eine Folge kleiner Entrauschungsschritte ein neues Bild hervorbringen?
- Ein Modell lernt statistische Rückwärtsschritte für künstlich gestörte Beispiele.
- Beim Erzeugen beginnt es mit Zufall und entwickelt daraus eine mögliche Ausgabe.
- Eine plausible Ausgabe ist weder automatisch ein reales Ereignis noch garantiert frei von erinnerten Trainingsmustern.
- Zeitliche Einordnung
- 2015: Diffusionsidee · 2020: DDPM · 2021/2022: latente Diffusion
- Orte und Regionen
- Internationale Forschung in den USA und Europa
- Historisch Beteiligte
- Jascha Sohl-Dickstein und Team; Jonathan Ho, Ajay Jain, Pieter Abbeel; Robin Rombach und Team
Eine Form erscheint
Drei Tafeln zeigen eine kleine Verwandlung. Links liegt farbige Körnung, in der Mitte zeichnet sich eine Form ab, rechts ist eine Birne zu erkennen. Die Zeichnung lädt zu einer naheliegenden Geschichte ein: Unter dem Rauschen habe die fertige Birne gewartet. Für das Erzeugen eines neuen Bildes wäre diese Geschichte jedoch irreführend. Aus einem zufälligen Anfang können verschiedene passende Ergebnisse entstehen.
Die Tafeln sind als eigener didaktischer Vergleich angelegt. Sie sind weder ein Beleg für die Leistung eines bestimmten Produkts noch ein Protokoll seiner internen Schritte. Im Exponat geht es um die Frage, welche Art Aufgabe ein Modell lernen kann, wenn wir bekannte Beispiele absichtlich stören.
Die Rückrichtung wird zur Lernaufgabe
Sohl-Dickstein und Mitforschende beschrieben 2015 ein Verfahren, das komplexe Daten schrittweise in eine einfachere Zufallsverteilung überführt. Die Rückrichtung wird gelernt: Wie können Übergänge aussehen, die wieder Struktur erzeugen? Die Inspiration stammt aus statistischer Physik, die konkrete Anwendung ist ein trainierbares Wahrscheinlichkeitsmodell. Die frühe Diffusionsarbeit
Ein Vergleich hilft, die Schwierigkeit einzugrenzen. Du kannst einen sauber gedruckten Punkt durch zufällige Flecken schlechter erkennbar machen. Aus der völlig gestörten Fläche lässt sich der ursprüngliche Punkt allein aber nicht beliebig genau wiederherstellen. Zusätzliche Annahmen über mögliche Ausgangsmuster verändern die Aufgabe. Lernen liefert hier eine statistische Orientierung, keine Garantie, verlorene Einzelheiten eindeutig zurückzuholen.
2020: Das Rauschen vorhersagen
Ho, Jain und Abbeel zeigten mit DDPM 2020 eine besonders wirksame Form dieses Ansatzes. Beim Training wird ein Beispiel mit einer bekannten Menge zufälligen Rauschens kombiniert. Das Netz erhält die gestörte Version und die Information über den Zeitschritt; in einer wichtigen Formulierung soll es das hinzugefügte Rauschen vorhersagen. Die Abweichung dient als Trainingssignal. DDPM, Trainingsverfahren
Das Modell muss dafür keine Beschriftung „Birne“ zu jeder Störung erhalten. Es lernt an der Beziehung zwischen Beispiel, hinzugefügter Störung und resultierender Eingabe. Im Training können unterschiedliche Störungsstufen ausgewählt werden. Eine neue Ausgabe entsteht anschließend durch eine Folge gelernter Rückwärtsschritte, beginnend bei Zufall. Training und Erzeugung sind damit verwandte, aber verschiedene Abläufe.
Warum zweimal nicht dasselbe entstehen muss
Stell dir vor, auf einer Tafel ist nur noch ein grober grüner Fleck erkennbar. Mehrere Formen könnten dazu passen. Soll er eine Birne, ein Blatt oder etwas ganz anderes werden? Dieses erfundene Beispiel verdeutlicht die Mehrdeutigkeit. Eine Wahrscheinlichkeitsverteilung beschreibt Möglichkeiten; sie ist kein einzelnes verborgenes Bild, das nur freigelegt werden müsste.
Bei einer angeleiteten Bilderzeugung kommen weitere Bedingungen hinzu. Sie schränken Möglichkeiten ein, ohne jede Einzelheit festzulegen. Für den Umgang mit solchen Bildern ist das wesentlich: Ein überzeugender Schatten und eine glaubwürdige Oberfläche belegen nicht, dass das dargestellte Objekt jemals fotografiert wurde. Die visuelle Plausibilität beantwortet eine andere Frage als die dokumentarische Herkunft.
Ein kompakter Raum für das Bild
Die 2021 als Preprint vorgestellte und 2022 auf der CVPR veröffentlichte Arbeit von Rombach und Mitforschenden verschiebt die Diffusion in eine gelernte kompakte Repräsentation. Ein Autoencoder vermittelt zwischen Bild und latentem Raum. Das reduziert in den untersuchten Verfahren den Rechenaufwand gegenüber der unmittelbaren Verarbeitung aller Bildpunkte. Cross-Attention ermöglicht zusätzliche Bedingungen wie Text. Latente Diffusionsmodelle
„Latent“ bezeichnet hier keine unsichtbare zweite Wirklichkeit. Es geht um eine rechnerische Darstellung. Kompression und anschließende Rückübersetzung sind eigene Teile des Systems. Deshalb lässt sich die Qualität eines Generators nicht aus einem einzigen Begriff ableiten; mehrere gelernte Komponenten und Entscheidungen wirken zusammen.
Neue Bilder und erinnerte Vorlagen
Ein generatives Verfahren kann neue Kombinationen bilden. Daraus folgt nicht, dass es grundsätzlich niemals Trainingsbeispiele reproduziert. Carlini und Mitforschende extrahierten 2023 gezielt zahlreiche Trainingsbilder aus untersuchten Diffusionsmodellen. Ihre Arbeit zeigt, dass Memorisation ein reales, prüfbares Verhalten sein kann. Untersuchung zur Extraktion von Trainingsdaten
Der Befund rechtfertigt weder die Behauptung, jede Ausgabe sei eine Kopie, noch die gegenteilige pauschale Entwarnung. Entscheidend sind das konkrete Modell, seine Daten und die untersuchte Ausgabe. Für unser Museum heißt das praktisch: Bilder werden individuell beauftragt, tatsächlich angesehen und mit ihrem Entstehungsweg dokumentiert. Ihre künstlerische Funktion bleibt im Besuchertext erkennbar.
Was die letzte Tafel offenlässt
Du kannst an der fertigen Birne drei getrennte Fragen stellen. Ist sie als Birne erkennbar? Entspricht sie einer gewünschten Darstellung? Hat es genau dieses Objekt in genau dieser Szene gegeben? Eine einzige schöne Tafel beantwortet diese Fragen nicht gemeinsam. Eine geeignete Prüfung muss sich jeweils auf die beabsichtigte Aussage richten.
Im weiteren Raum begegnet das Prinzip der Rückmeldung erneut. Ein System kann durch Beispiele, durch den Erfolg von Handlungen oder durch menschliche Vergleiche verbessert werden. Welche Rückmeldung verfügbar ist, prägt die Aufgabe und ihre Grenzen ebenso stark wie die sichtbare Eleganz der Ausgabe.
Grenzen des Wissens
Was offen bleibt
Die Birnenfolge ist eine didaktische Zeichnung, kein aus einem konkreten Generator exportierter Ablauf. Verfahren, Schrittzahlen, Konditionierung und Verhalten unterscheiden sich zwischen Modellen.
Begriffe verstehen
Diffusionsmodell
Ein generatives Modell, das durch gelernte Rückwärtsschritte zu einem Rauschprozess neue Daten erzeugen kann.
Rauschen
Zufällige Veränderungen von Werten; beim Training wird eine bekannte Störung zu einem Beispiel hinzugefügt.
← Zur TextstelleLatenter Raum
Eine gelernte, kompakte Repräsentation, in der Daten verarbeitet und anschließend wieder in ein Bild übersetzt werden können.
Konditionierung
Zusätzliche Vorgaben, etwa eine Textbeschreibung, die eine erzeugte Ausgabe beeinflussen.
Quellen und Nachweise
Die Quellen sind den Aussagen im Text zugeordnet. Originalstudien, Sammlungstexte und eigene Einordnung erfüllen unterschiedliche Aufgaben. Einige Fachtexte sind beim Verlag nur teilweise frei zugänglich.
- Die frühe Diffusionsidee
Sohl-Dickstein, J., Weiss, E. A., Maheswaranathan, N. und Ganguli, S. (2015): Deep Unsupervised Learning using Nonequilibrium Thermodynamics. arXiv:1503.03585.
Vorwärts schrittweise Struktur zerstören; statistische Rückwärtsübergänge lernen.
← Zur Textstelle: Die Rückrichtung wird zur Lernaufgabe - Denoising Diffusion Probabilistic Models
Ho, J., Jain, A. und Abbeel, P. (2020): Denoising Diffusion Probabilistic Models. NeurIPS 2020. arXiv:2006.11239.
Rauschvorhersage, zufällige Zeitschritte im Training und iterative Erzeugung; keine Wiedergewinnung eines eindeutig im Rauschen versteckten Originals.
← Zur Textstelle: 2020: Das Rauschen vorhersagen - Diffusion im kompakten Bildraum
Rombach, R., Blattmann, A., Lorenz, D., Esser, P. und Ommer, B. (2022): High-Resolution Image Synthesis with Latent Diffusion Models. CVPR 2022; Preprint 2021. arXiv:2112.10752.
Autoencoder-Kompression und Cross-Attention für Bedingungen wie Text; Kostenreduktion gegenüber Pixel-Diffusion in der Studie.
← Zur Textstelle: Ein kompakter Raum für das Bild - Wenn Trainingsbilder wieder auftauchen
Carlini, N. et al. (2023): Extracting Training Data from Diffusion Models. arXiv:2301.13188.
Gezielte Extraktion von Trainingsbeispielen aus untersuchten Modellen; weder jede Ausgabe als Kopie noch vollständige Freiheit von Memorisation behaupten.
← Zur Textstelle: Neue Bilder und erinnerte Vorlagen
Redaktion: Benjamin Metzig. Erste vollständige Fassung. Recherche- und Bearbeitungsstand: 5. September 2026. Generative KI diente als Werkzeug für Text und Bild.
Hinweis oder Korrektur an die RedaktionZusammenhänge entdecken
Exponat · Modellarchitektur · Transformer
Aufmerksamkeit verbindet
Wie kann ein Modell weit auseinanderliegende Teile einer Eingabe miteinander in Beziehung setzen?
Exponat erkunden ↗
Exponat · Wissenschaftliches Modell · AlphaFold
Proteinform vorhersagen
Wie weit lässt sich aus einer Aminosäurefolge auf die räumliche Struktur eines Proteins schließen?
Exponat erkunden ↗