Exponat 29 · Bestärkendes Lernen · AlphaGo
Lernen durch Rückmeldung
AlphaGo verband gelernte Bewertungen mit Suche. AlphaGo Zero verschob 2017 das Training auf Selbstspiel ohne menschliche Beispielpartien. Das Spielbrett zeigt zugleich die Stärke und die besondere Abgeschlossenheit dieser Lernumgebung.
4 Minuten Haupttext · Stand: 5. September 2026
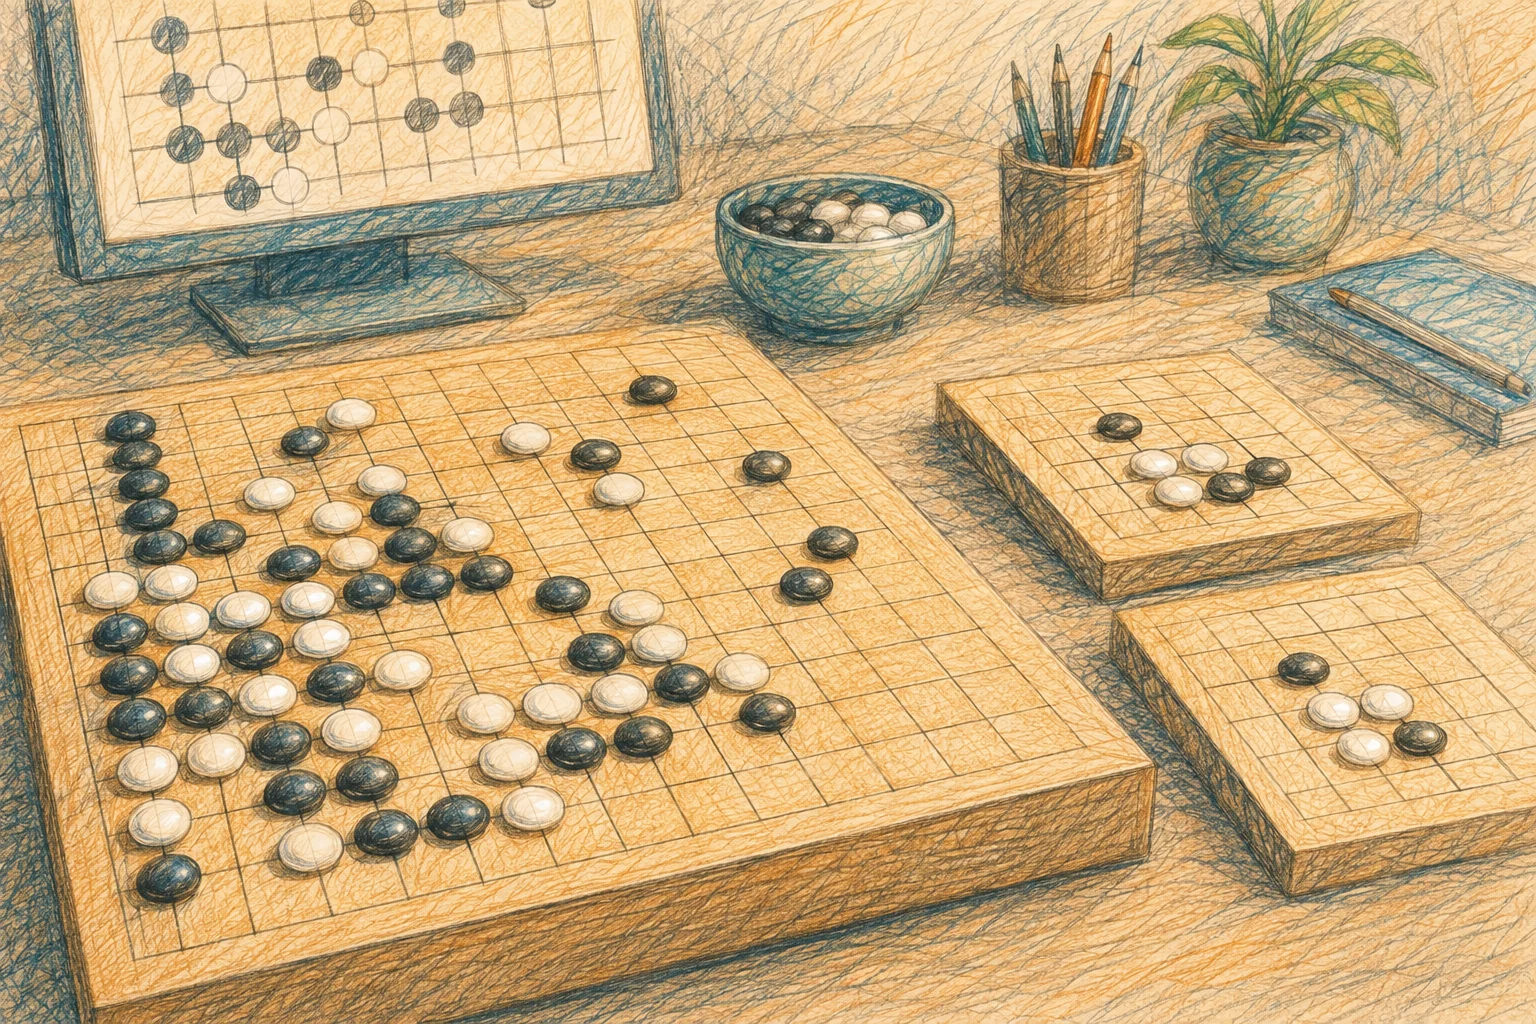 Bild vergrößern ↗
Auf einen Blick
Wie können eigene Versuche ein System besser machen, wenn niemand jeden einzelnen Zug vorgibt?
- Bestärkendes Lernen bewertet Handlungsfolgen anhand eines vorgegebenen Rückmeldesignals.
- AlphaGo Zero erzeugte seine Trainingspartien selbst und verband Lernen mit vorausschauender Suche.
- Keine menschlichen Beispielzüge bedeutet nicht: keine menschlichen Voraussetzungen.
- Zeitliche Einordnung
- 2015/2016: AlphaGo · 2017: AlphaGo Zero und AlphaZero
- Orte und Regionen
- DeepMind, Großbritannien; internationaler Go-Sport
- Historisch Beteiligte
- David Silver, Aja Huang, Julian Schrittwieser und die beteiligten Forschungsteams
Ein guter Zug zeigt sich nicht immer sofort
Du setzt einen Stein. Noch ist die Partie nicht gewonnen. Vielleicht wird seine Bedeutung erst viele Züge später sichtbar. Das ist eine andere Lernaufgabe als das Zuordnen einer einzelnen Bildkarte zu einer bekannten Beschriftung. Eine Handlung verändert die Situation, in der die nächste Entscheidung getroffen wird. Die Qualität einer Folge lässt sich nicht immer aus der unmittelbaren Wirkung ihres ersten Schritts ablesen.
Die beiden kleinen Bretter neben dem Hauptbrett stehen für mögliche Fortsetzungen. Sie laden dich ein, zwischen dem aktuellen Zustand und einer erwarteten Zukunft zu unterscheiden. Die Zeichnung rekonstruiert keine bekannte Partie. Ihr Zweck ist, das Problem der zeitlich verzögerten Rückmeldung anschaulich zu machen.
AlphaGo: Lernen und Suchen arbeiten zusammen
Die 2016 veröffentlichte AlphaGo-Arbeit verband mehrere Verfahren. Ein Strategienetz lernte zunächst aus menschlichen Beispielzügen und wurde durch Selbstspiel weiterentwickelt. Ein Wertnetz schätzte, welche Stellungen zu einem Sieg führen könnten. Eine Baumsuche nutzte diese gelernten Komponenten, um Fortsetzungen gezielter zu untersuchen. Die Veröffentlichung berichtete unter anderem den Sieg gegen Europameister Fan Hui im Oktober 2015. Die frühe AlphaGo-Veröffentlichung
Das ist historisch genauer als das Bild eines Programms, das bloß alle möglichen Partien vollständig ausrechnet. Lernen machte Bewertungen und Vorschläge verfügbar; Suche nutzte sie bei der Auswahl von Handlungen. Der Erfolg gehört zu ihrer Verbindung, nicht zu einem einzigen magischen Baustein.
2017: Die Beispiele entstehen im Spiel
AlphaGo Zero startete sein Training ohne menschliche Beispielpartien. Das 2017 beschriebene System spielte gegen sich selbst und nutzte ein gemeinsames Netz für Zugwahrscheinlichkeiten und Stellungsbewertung. Vorausschauende Suche war Teil der Trainingsschleife. Die im Selbstspiel entstehenden Ergebnisse verbesserten wiederum das Netz. AlphaGo Zero im Original
Die Formulierung „ohne menschliches Wissen“ im Titel muss sorgfältig gelesen werden. Spielregeln, erlaubte Handlungen, die Definition des Ergebnisses und die technische Konstruktion kamen weiterhin von Menschen. Weggelassen wurden insbesondere die zuvor verwendeten menschlichen Beispielpartien. Die präzise Neuerung ist interessant genug, ohne daraus einen voraussetzungslosen Ursprung von Wissen zu machen.
Ein eigenes Gedankenexperiment über Rückmeldung
Stell dir ein erfundenes Brettspiel vor, in dem nur der Endsieg zählt. Nun belohnst du dein Lernsystem versehentlich für jeden zusätzlich gesetzten Stein. Die Rückmeldung wäre zwar leicht zu zählen, aber sie würde eine andere Aufgabe formulieren. Ein System könnte dann eine Folge bevorzugen, die viele Steine enthält, obwohl sie das Spiel verliert. Dieses Beispiel beschreibt keinen konkreten AlphaGo-Fehler. Es zeigt eine allgemeine logische Unterscheidung zwischen Messsignal und beabsichtigtem Ziel.
Ein Belohnungssignal ist deshalb nicht automatisch eine vollständige Beschreibung dessen, was Menschen wünschen. Schon bei einem selbst entworfenen Spiel lässt sich die Frage stellen: Was würde eine Strategie maximieren, wenn sie die angegebene Rückmeldung sehr erfolgreich ausnutzt? Die Antwort kann helfen, die Aufgabenbeschreibung vor dem Training genauer zu machen.
AlphaZero erweitert den Rahmen
Der im Dezember 2017 veröffentlichte AlphaZero-Preprint übertrug ein verallgemeinertes Selbstspielverfahren auf Go, Schach und Shōgi. Jeweils ausgehend von Regeln und zufälligem Spiel entwickelte es starke Spielstrategien. Die Arbeit betrifft ein übertragbares Verfahren, das für die jeweiligen Spiele trainiert wurde. AlphaZero und weitere Brettspiele
Ein solches Ergebnis sollte nicht so erzählt werden, als hätte eine unverändert trainierte einzelne Instanz plötzlich jede andere Aufgabe beherrscht. Das Verfahren und sein jeweiliger Trainingszustand sind verschiedene Dinge. Auch ein gemeinsames Rezept kann mehrere getrennte Lernprozesse hervorbringen. Diese Unterscheidung hilft beim Einordnen vieler späterer Erfolgsmeldungen über lernende Systeme.
Warum das Brett eine besondere Umgebung ist
Auf unserem Brett sind die erlaubten Positionen und das Ziel ausdrücklich festgelegt. Man kann Partien wiederholen und ihre Ergebnisse unter denselben Regeln vergleichen. Für eine offene Alltagssituation müsste zuerst geklärt werden, welche Beobachtungen verfügbar sind, welche Handlungen erlaubt sein sollen und woran ein gutes Ergebnis erkannt wird. Ein Sieg unter Spielregeln beantwortet diese zusätzlichen Fragen nicht.
Eine andere Forschungslinie lernte Ziele deshalb aus menschlichen Vergleichen kurzer Handlungsabschnitte. Christiano und Mitforschende zeigten 2017 entsprechende Versuche mit Spielen und simulierter Bewegung. Lernen aus menschlichen Präferenzen Der Übergang führt zu einem neuen Problem: Auch die Qualität und Bedeutung solcher Vergleiche muss untersucht werden.
Was du vom Spielbrett mitnehmen kannst
Das Exponat zeigt eine produktive Schleife: Handeln erzeugt Erfahrungen, Erfahrungen verändern eine Strategie, die veränderte Strategie ermöglicht andere Handlungen. Um einen konkreten Erfolg einzuordnen, lohnt sich ein Blick auf alle Teile. Wer setzt die Regeln? Welches Ergebnis wird gezählt? Welche Ressourcen stehen für die Versuche bereit? Gegen welche Vergleichssysteme wird geprüft?
Beim Weitergehen vom Spiel zur Sprache wird der Maßstab weniger eindeutig. Eine Antwort kann höflich, hilfreich, überzeugend und trotzdem falsch sein. Der folgende Gegenstand untersucht, was geschieht, wenn Menschen solche Antworten vergleichen und ihre Urteile zum Trainingsmaterial werden.
Grenzen des Wissens
Was offen bleibt
Erfolge in Go, Schach oder Shōgi betreffen klar definierte Spiele. Sie belegen weder eine universelle Intelligenz noch die unveränderte Übertragbarkeit auf offene Lebenssituationen.
Begriffe verstehen
Bestärkendes Lernen
Lernen einer Handlungsstrategie durch Rückmeldungen über Ergebnisse von Handlungen; auch Reinforcement Learning genannt.
Strategie
Eine Regel oder gelernte Verteilung dafür, welche Handlung in einer gegebenen Situation gewählt wird; im Fachkontext Policy.
← Zur TextstelleWertfunktion
Eine Schätzung, wie günstig eine Situation im Hinblick auf das festgelegte zukünftige Ergebnis ist.
Selbstspiel
Training anhand von Partien, in denen Varianten eines Systems gegeneinander spielen und dabei neue Beispiele erzeugen.
← Zur TextstelleQuellen und Nachweise
Die Quellen sind den Aussagen im Text zugeordnet. Originalstudien, Sammlungstexte und eigene Einordnung erfüllen unterschiedliche Aufgaben. Einige Fachtexte sind beim Verlag nur teilweise frei zugänglich.
- AlphaGo verbindet gelernte Bewertung und Suche
Silver, D. et al. (2016): Mastering the game of Go with deep neural networks and tree search. Nature 529, 484–489. DOI: 10.1038/nature16961.
Die frühe Version kombiniert menschliche Partien, Selbstspiel, Strategie-/Wertnetze und Baumsuche.
← Zur Textstelle: AlphaGo: Lernen und Suchen arbeiten zusammen - AlphaGo Zero lernt im Selbstspiel
Silver, D. et al. (2017): Mastering the game of Go without human knowledge. Nature 550, 354–359. DOI: 10.1038/nature24270.
Keine menschlichen Beispielpartien; Spielregeln, Ziel und Architektur bleiben von Menschen gesetzte Voraussetzungen.
← Zur Textstelle: 2017: Die Beispiele entstehen im Spiel - AlphaZero überträgt das Verfahren auf weitere Spiele
Silver, D. et al. (2017): Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm. arXiv:1712.01815.
Verallgemeinertes Verfahren, je Spiel trainiert; kein universeller Problemlöser und kein Beleg für Transfer einer einzelnen trainierten Instanz ohne Training.
← Zur Textstelle: AlphaZero erweitert den Rahmen - Aus menschlichen Vergleichen ein Ziel lernen
Christiano, P. et al. (2017): Deep reinforcement learning from human preferences. arXiv:1706.03741.
Vergleiche kurzer Handlungsabschnitte; Atari und simulierte Bewegung. Lernziel kann aus Präferenzen geschätzt werden.
← Zur Textstelle: Warum das Brett eine besondere Umgebung ist
Redaktion: Benjamin Metzig. Erste vollständige Fassung. Recherche- und Bearbeitungsstand: 5. September 2026. Generative KI diente als Werkzeug für Text und Bild.
Hinweis oder Korrektur an die RedaktionZusammenhänge entdecken
Exponat · Nachtraining · Lernen aus Präferenzen
Menschen bewerten Antworten
Wie lässt sich ein Modell an hilfreichen Antworten ausrichten, wenn es keine einzige richtige Formulierung gibt?
Exponat erkunden ↗
Exponat · Lernverfahren · Bildklassifikation
Bildnetze lernen Merkmale
Wie lernt ein Rechner, Bilder zu unterscheiden, ohne dass jemand jede Form einzeln programmiert?
Exponat erkunden ↗