Exponat 26 · Lernverfahren · Bildklassifikation
Bildnetze lernen Merkmale
AlexNet verband 2012 große Bildsammlungen, trainierbare Faltungsnetze und Grafikprozessoren. Das Exponat erklärt, was dabei gelernt wird und warum ein guter Testwert noch keine zuverlässige Wahrnehmung in jeder Umgebung bedeutet.
4 Minuten Haupttext · Stand: 5. September 2026
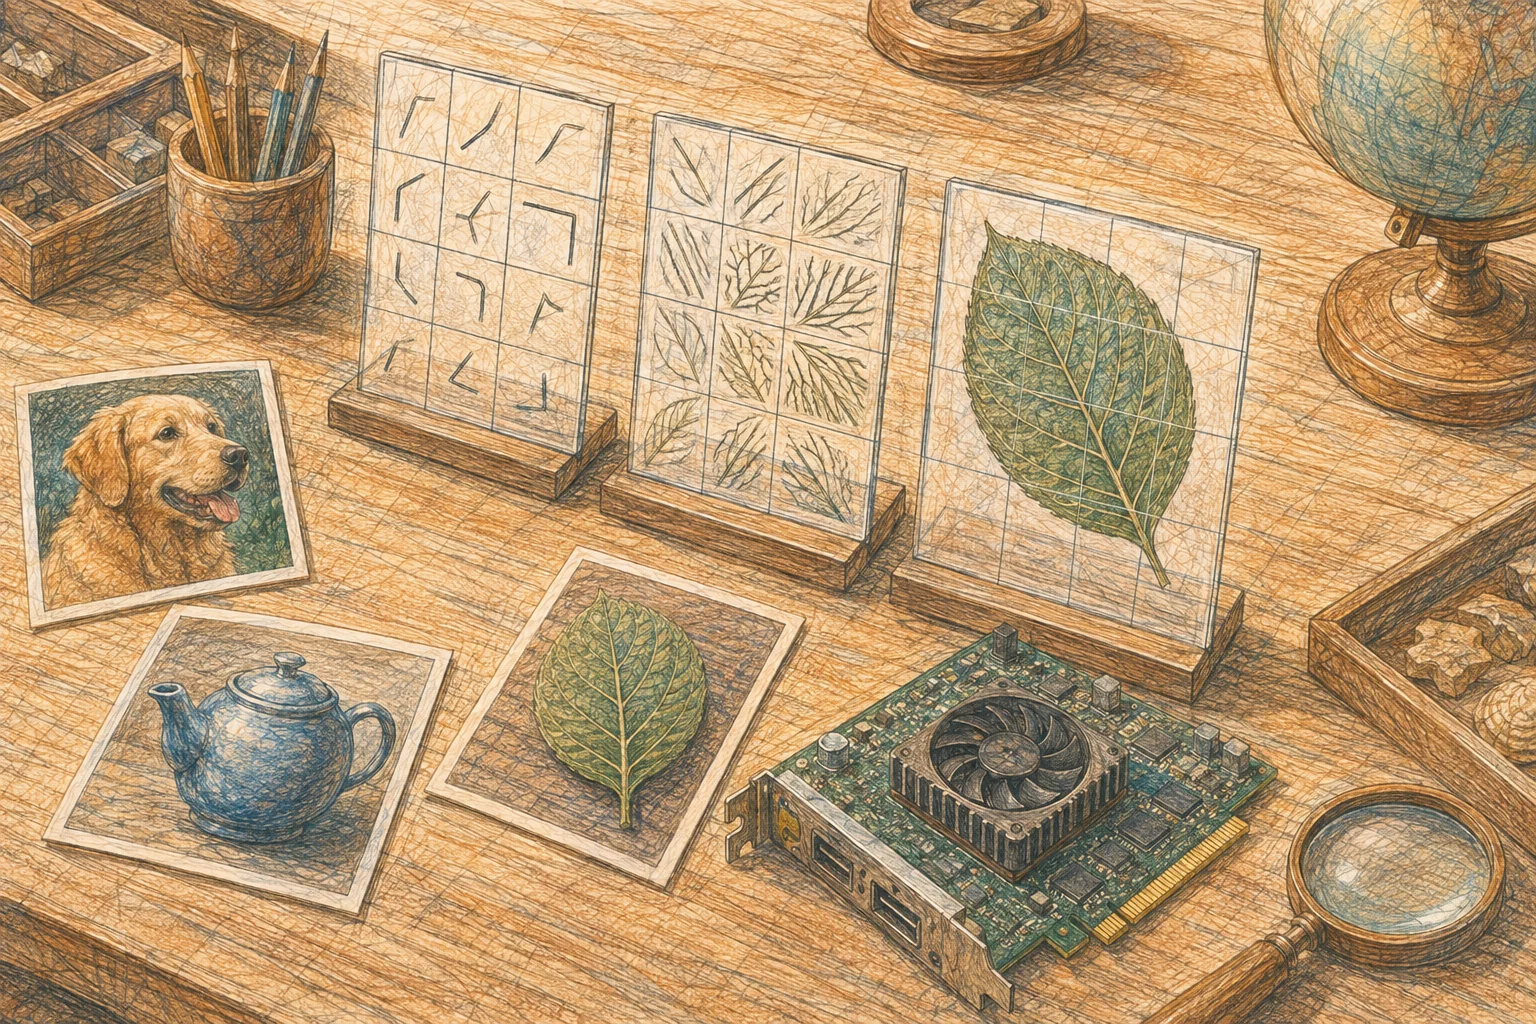 Bild vergrößern ↗
Auf einen Blick
Wie lernt ein Rechner, Bilder zu unterscheiden, ohne dass jemand jede Form einzeln programmiert?
- Ein Bildnetz passt seine Merkmalsverarbeitung an Beispiele und ein vorgegebenes Ziel an.
- Die Ergebnisse von 2012 betreffen eine bestimmte Klassifikationsaufgabe.
- Welche Bildhinweise ein Modell nutzt, muss mit passenden Versuchen untersucht werden.
- Zeitliche Einordnung
- 2012 · mit Grundlagen davor und Folgeprüfungen bis 2026
- Orte und Regionen
- Toronto; internationaler ImageNet-Wettbewerb
- Historisch Beteiligte
- Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton und die Teams hinter Daten und Wettbewerb
Ein Bild, tausend mögliche Schubladen
Auf dem Tisch liegen ein Hund, eine Teekanne und ein Blatt als Bildkarten. Du erkennst vermutlich schnell, was gemeint ist. Für einen Rechner beginnt die Aufgabe mit Zahlen für die Helligkeit und Farbe einzelner Bildpunkte. Daraus soll eine passende Kategorie entstehen. Die Frage lautet hier ausdrücklich: Welche der vorgegebenen Klassen passt zum Bild? Sie umfasst weder alle möglichen Dinge noch jede Bedeutung einer Szene.
Als eigenes Gedankenbeispiel kannst du die Karten anders beschriften: mit „lebendig“, „künstlich“ oder „grün“. Sofort entsteht eine andere Lernaufgabe. Dasselbe Bildmaterial könnte nun andere Eigenschaften nützlich machen. Schon die Wahl der Kategorien bestimmt daher mit, was ein späterer Erfolg überhaupt bedeutet. Die Schubladen werden nicht von der Natur mitgeliefert.
Aus Bildpunkten werden brauchbare Unterschiede
Ein neuronales Netz verknüpft Eingaben über mehrere Rechenschichten. Einstellbare Gewichte bestimmen, wie stark Signale einfließen; nichtlineare Verarbeitung ermöglicht komplexere Zusammenhänge. Beim Training werden diese Einstellungen so angepasst, dass die Abweichung vom gewünschten Ergebnis kleiner wird. Verborgene Schichten sind dabei interne Zahlenrepräsentationen, keine geheimen Bilder im Kopf einer Maschine. Grundlagen neuronaler Netze
Anschaulich lässt sich das an den durchsichtigen Tafeln im Bild verfolgen: Eine hebt Konturen hervor, eine andere Muster. Tatsächliche Merkmale müssen nicht so sauber voneinander getrennt oder für uns direkt benennbar sein. Die Tafeln sind eine Vermittlungsidee. Sie erklären, weshalb mehr als ein Verarbeitungsschritt hilfreich sein kann; sie behaupten keine genaue Innenansicht eines bestimmten Netzes.
2012: Mehrere Entwicklungen greifen ineinander
Alex Krizhevsky, Ilya Sutskever und Geoffrey Hinton beschrieben 2012 ein tiefes Faltungsnetz, das an ImageNet-Bildern trainiert wurde. Filter mit gemeinsamen Gewichten verarbeiteten lokale Bildbereiche. Fünf Faltungsschichten und drei vollständig verbundene Schichten bildeten das Netz. Grafikprozessoren machten die umfangreichen Berechnungen praktikabel; weitere Entscheidungen erleichterten das Training und begrenzten Überanpassung. Das Ergebnis entstand aus dem Zusammenspiel von Architektur, Beispieldaten, Rechenleistung und Verfahren. Die AlexNet-Originalveröffentlichung
Die Arbeit erfand weder neuronale Netze noch die Faltung aus dem Nichts. Ihr historischer Stellenwert liegt in einer wirksamen Kombination und einem deutlich sichtbaren Vergleichsergebnis. Zur Entdeckungsgeschichte gehören deshalb auch die Menschen, die Bilder sammelten, Kategorien festlegten und die gemeinsame Prüfung organisierten.
Was die berühmte Zahl wirklich misst
Die Wettbewerbsversion erreichte 2012 laut Originalveröffentlichung einen Top-5-Fehler von 15,3 Prozent; der zweitplatzierte Beitrag lag dort bei 26,2 Prozent. Die offizielle Ergebnisliste führt das Team als SuperVision. Diese Werte beziehen sich auf den Klassifikationstest und seine Auswertung. Ergebnisse in der Publikation Offizielle Wettbewerbsergebnisse
Top 5 bedeutet: Die richtige Vorgabe darf unter fünf Vorschlägen stehen. Ein erster, falscher Vorschlag muss also noch keinen Fehler in dieser Kennzahl ergeben. Die Zahl ist damit weder eine allgemeine Sehfähigkeit noch direkt mit einer Aufgabe vergleichbar, die nur eine Antwort erlaubt. Für einen fairen Vergleich gehören Aufgabe, Datensatz, Auswertungsregel und Testbedingungen immer zusammen.
Die nächste Aufnahme ist der eigentliche Test
Ein Modell kann sich zu eng an bekannte Beispiele anpassen. Deshalb werden Trainingsdaten, Daten zur Auswahl von Einstellungen und abschließende Testdaten getrennt. Duplikate oder wiederholte Entscheidungen anhand desselben Tests können das Bild verzerren. Außerdem müssen die Beispiele zu den späteren Einsatzbedingungen passen. Ein sorgfältiger Lehrtext von Google macht diese Trennung und ihre Grenzen ausdrücklich. Training, Validierung und Test
Stell dir für unser Kartenspiel ausschließlich Teekannen vor hellem Hintergrund vor. Ein zusätzlicher Versuch mit dunklen Hintergründen wäre dann aufschlussreicher als immer neue Wiederholungen derselben Karten. Das ist ein erfundenes Beispiel zur Prüflogik, kein Bericht über AlexNet. Es zeigt, weshalb eine vermutete Abkürzung gezielt herausgefordert werden sollte.
Form, Oberfläche und eine offene methodische Frage
Geirhos und Mitforschende untersuchten 2019 Bilder, in denen Form und Textur widersprüchliche Hinweise gaben. In ihren Versuchen nutzten untersuchte ImageNet-Netze Texturhinweise stärker als Menschen; verändertes Training verschob dieses Verhalten. Das war eine konkrete Messung unter kontrollierten Bedingungen. Der Form-Textur-Vergleich
Eine bei NeurIPS 2025 angenommene Arbeit von Burgert und Mitforschenden setzt anders an: Sie unterdrückt Merkmale kontrolliert und kritisiert die Verallgemeinerung der früheren Konfliktaufgabe. Ihre Ergebnisse betonen lokale Formmerkmale und Unterschiede zwischen Anwendungsgebieten. Die methodische Gegenprüfung Das Museum stellt deshalb keine ewige Regel „Netze sehen nur Textur“ auf. Wissenschaftlicher Fortschritt umfasst auch bessere Fragen an bereits erfolgreiche Verfahren.
Die gelernte Lösung und die gestellte Aufgabe
Betrachte noch einmal die Bildkarten. Welche Aufnahme würdest du ergänzen, um die vermutete Strategie genauer zu prüfen? Ein veränderter Hintergrund, eine ungewöhnliche Perspektive und eine neue Objektart untersuchen verschiedene Grenzen. Bevor du einen Test wählst, musst du sagen, welche Behauptung er stützen oder widerlegen soll.
Der nächste Gegenstand im Raum verändert die Verbindungen zwischen Eingaben. Statt überall dieselben lokalen Bildfilter anzuwenden, kann ein Aufmerksamkeitsmechanismus Beziehungen unterschiedlich gewichten. Die Grundfrage bleibt: Welche Verarbeitung wird gelernt, woran wird ihr Erfolg gemessen und wie weit reicht der Nachweis?
Grenzen des Wissens
Was offen bleibt
Hohe Trefferraten erklären nicht automatisch die Entscheidungsstrategie. Aussagen über Form- oder Texturvorlieben hängen von Modellen, Trainingsdaten und Prüfverfahren ab.
Begriffe verstehen
Faltung
Eine wiederholt an verschiedenen Bildstellen angewandte Rechenoperation mit gemeinsamen Filtergewichten.
← Zur TextstelleTrainingsdaten
Beispiele, an denen die einstellbaren Parameter eines Modells angepasst werden.
← Zur TextstelleTop-5-Fehler
Ein Fall zählt als Fehler, wenn die vorgegebene richtige Klasse unter den fünf höchstbewerteten Vorschlägen fehlt.
← Zur TextstelleGeneralisierung
Die Fähigkeit eines gelernten Modells, auch auf bisher nicht verwendeten Beispielen brauchbare Ergebnisse zu liefern.
Quellen und Nachweise
Die Quellen sind den Aussagen im Text zugeordnet. Originalstudien, Sammlungstexte und eigene Einordnung erfüllen unterschiedliche Aufgaben. Einige Fachtexte sind beim Verlag nur teilweise frei zugänglich.
- AlexNet: Bildklassifikation mit tiefen Faltungsnetzen
Krizhevsky, A., Sutskever, I. und Hinton, G. E. (2012): ImageNet Classification with Deep Convolutional Neural Networks. Advances in Neural Information Processing Systems 25.
2012-Wettbewerbsversion: 15,3 % Top-5-Fehler; nicht mit abweichenden Zwischenständen im HTML-Abstract vermischen.
← Zur Textstelle 1: 2012: Mehrere Entwicklungen greifen ineinander← Zur Textstelle 2: Was die berühmte Zahl wirklich misst - Die offiziellen ImageNet-Ergebnisse 2012
ImageNet (2012): Large Scale Visual Recognition Challenge 2012, Results.
Klassifikation und Lokalisierung getrennte Aufgaben; SuperVision liegt bei der Klassifikation vorn.
← Zur Textstelle: Was die berühmte Zahl wirklich misst - Wie neuronale Netze Merkmale verknüpfen
Google for Developers: Machine Learning Crash Course, Neural networks. Stand 25.8.2025.
Nichtlineare Muster, verborgene Schichten, Gewichte und Trainingsziel; keine Gleichsetzung mit biologischen Neuronen.
← Zur Textstelle: Aus Bildpunkten werden brauchbare Unterschiede - Training, Validierung und unabhängiger Test
Google for Developers: Datasets – Dividing the original dataset. Stand 3.12.2025.
Getrennte Daten, Duplikate, wiederholte Testnutzung und reale Einsatzbedingungen.
← Zur Textstelle: Die nächste Aufnahme ist der eigentliche Test - Form und Textur im Konflikttest
Geirhos, R. et al. (2019): ImageNet-trained CNNs are biased towards texture; increasing shape bias improves accuracy and robustness. ICLR 2019. arXiv:1811.12231.
Befunde für untersuchte Modelle und gezielte Form-Textur-Konflikte; kein universelles Gesetz aller Bildnetze.
← Zur Textstelle: Form, Oberfläche und eine offene methodische Frage - Eine neue Prüfung der Merkmalsnutzung
Burgert, T., Stoll, O., Rota, P. und Demir, B. (2025): ImageNet-trained CNNs are not biased towards texture: Revisiting feature reliance through controlled suppression. NeurIPS 2025. arXiv:2509.20234, Version 5 vom 9.1.2026.
Kontrollierte Unterdrückung statt erzwungener Konfliktwahl; lokale Formmerkmale und aufgabenspezifische Unterschiede. Aktuelle methodische Gegenperspektive.
← Zur Textstelle: Form, Oberfläche und eine offene methodische Frage
Redaktion: Benjamin Metzig. Erste vollständige Fassung. Recherche- und Bearbeitungsstand: 5. September 2026. Generative KI diente als Werkzeug für Text und Bild.
Hinweis oder Korrektur an die RedaktionZusammenhänge entdecken
Exponat · Modellarchitektur · Transformer
Aufmerksamkeit verbindet
Wie kann ein Modell weit auseinanderliegende Teile einer Eingabe miteinander in Beziehung setzen?
Exponat erkunden ↗
Exponat · Wissenschaftliches Modell · AlphaFold
Proteinform vorhersagen
Wie weit lässt sich aus einer Aminosäurefolge auf die räumliche Struktur eines Proteins schließen?
Exponat erkunden ↗