Exponat 06 · Brin und Pages Suchmaschinenprototyp von 1998
Treffer aus einem Index und aus Verweisen gewinnen
Ein Suchsystem sammelt Dokumente, ordnet Wörter in einem Index und berücksichtigt Beziehungen zwischen Seiten. Der Prototyp von 1998 nutzt gewichtete Verweise zusammen mit weiteren Treffereigenschaften. Die Reihenfolge ist ein berechnetes Auswahlresultat, keine fachliche Prüfung jedes Inhalts.
3 Minuten Haupttext · Stand: 8. September 2026
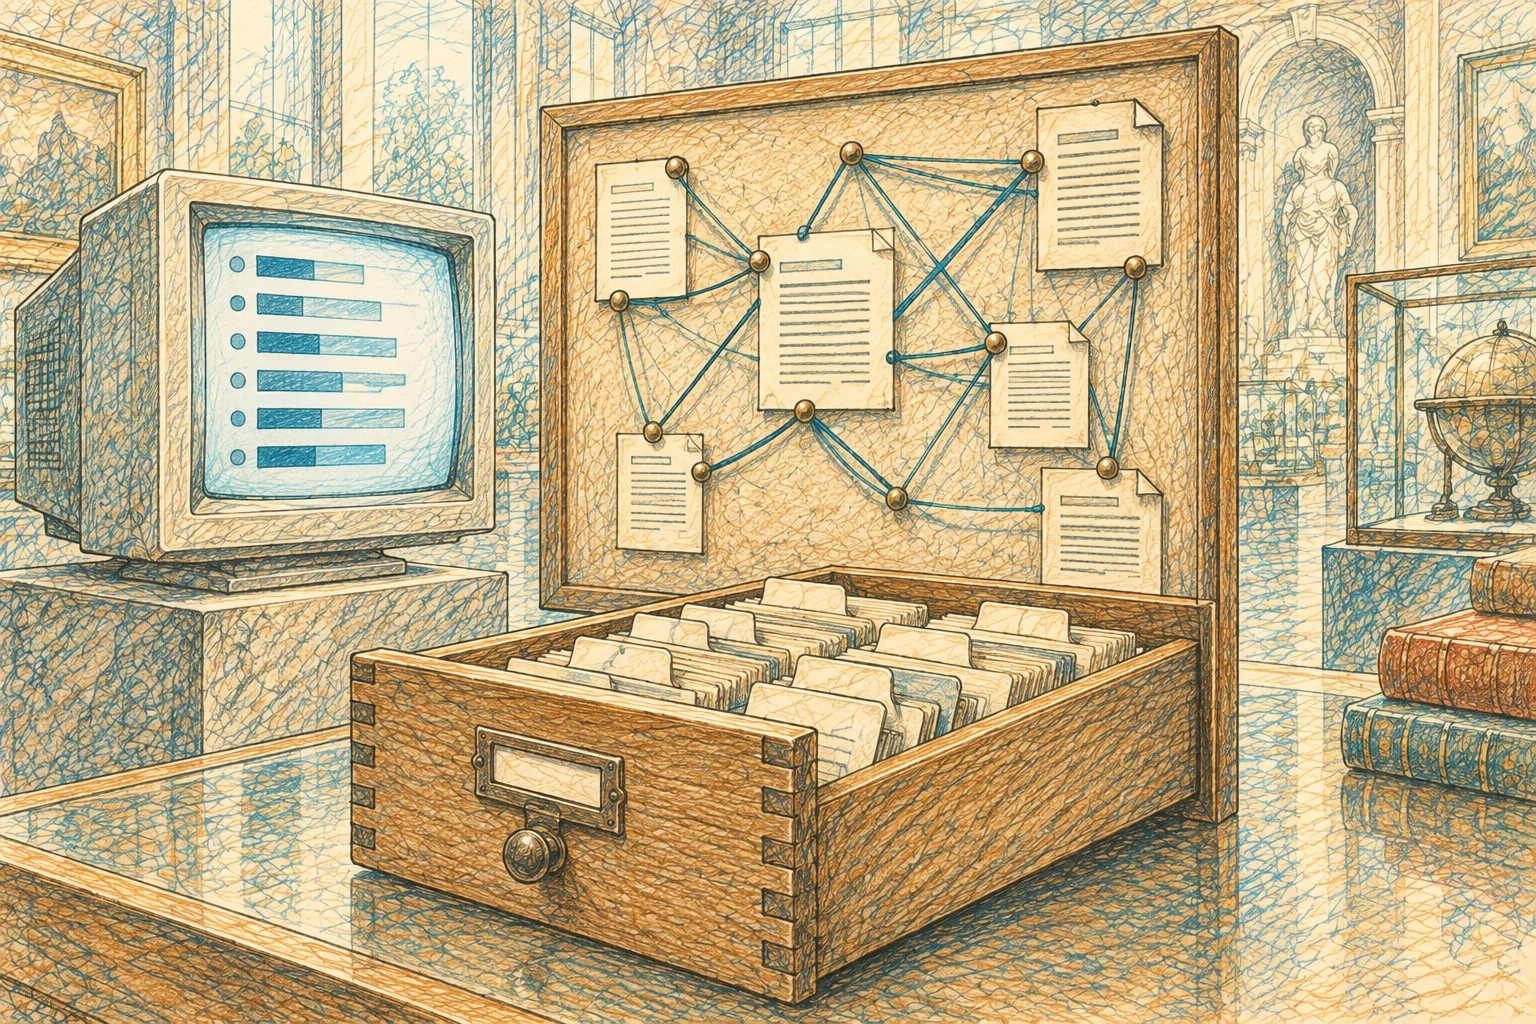 Bild vergrößern ↗
Auf einen Blick
Wie verbindet eine Suchmaschine Texttreffer mit Linkbeziehungen, und warum belegt ein hoher Rang keine Wahrheit?
- Crawlen, Indexieren und Beantworten einer Suchanfrage sind getrennte Schritte.
- Gewichtete Verweise sind mehr als eine rohe Zahl eingehender Links.
- Suchrang, Abdeckung und sachliche Richtigkeit sind unterschiedliche Eigenschaften.
- Zeitliche Einordnung
- 1998
- Orte und Regionen
- Stanford University, USA
- Historisch Beteiligte
- Sergey Brin, Lawrence Page, Scott Hassan, Alan Steremberg und weitere Mitwirkende
Eine Anfrage liest nicht das ganze Web neu
Eine Suchmaschine kann nicht sinnvoll bei jeder einzelnen Anfrage sämtliche erreichbaren Webseiten von vorn lesen. Der 1998 beschriebene Prototyp trennt deshalb das Sammeln von Dokumenten, ihre Speicherung und Aufbereitung von der späteren Bearbeitung einer Suchanfrage. Die Architektur des Prototyps
Crawler rufen Seiten ab, weitere Schritte erschließen ihre Inhalte für den Suchbestand. Die im Aufsatz genannten Größen und Laufzeiten gehören zu einem damaligen Forschungsprojekt. Sie sind keine Messung heutiger Suche und kein Nachweis, dass schon dieser Bestand sämtliche damals vorhandenen Seiten enthalten hätte.
Vom Wort zur Liste der Dokumente
Ein invertierter Index ordnet die Suche um: Statt jedes Dokument einzeln nach einem Wort zu durchsuchen, führt ein Eintrag für das Wort zu den bereits erfassten Dokumenten. Zusätzliche Angaben können Positionen und weitere Eigenschaften der Vorkommen berücksichtigen. Die Funktion des Index
Als eigene Denkstütze dient das Sachregister eines Buchs. Unter einem Begriff stehen die Seiten, auf denen er vorkommt. Das Beispiel erklärt die Richtung des Nachschlagens, nicht die genaue historische Speicherstruktur oder die Behandlung sämtlicher Wortformen. Ein Index ist nur so umfassend und aktuell wie sein zugrunde liegender Bestand.
Verweise werden nicht nur gezählt
PageRank berücksichtigt Verbindungen zwischen Seiten. Dabei hängt das Gewicht eines Verweises unter anderem vom Gewicht der verweisenden Seite und ihren ausgehenden Links ab. Es genügt daher nicht, einfach die rohe Zahl aller eingehenden Verweise zu zählen. Das Prinzip gewichteter Links
Der Aufsatz verbindet dieses Merkmal mit Texttreffern und weiteren Eigenschaften. Ein hoher struktureller Rang allein ist also nicht schon die vollständige Antwort auf jede Suchfrage. Die Station erläutert das qualitative Prinzip; die inkonsistente Normalisierung in der historischen Formeldarstellung wird nicht als scheinbar geprüfte Rechenanleitung wiedergegeben.
Was andere über ein Ziel schreiben
Das System verwendet auch Linktexte als Hinweise auf die Zielseite. Die Autoren erklären ausdrücklich, dass dieses Grundprinzip bereits andere Vorbilder besitzt. Ein Ziel kann dadurch in einem Suchzusammenhang auftauchen, obwohl es vom Crawler selbst noch nicht heruntergeladen wurde. Linktexte als zusätzliche Hinweise
Ein solcher Eintrag beweist dann weder die aktuelle Erreichbarkeit noch den tatsächlich vorhandenen Inhalt des Ziels. Der Hinweis eines verweisenden Dokuments und eine eigene Prüfung des Zielinhalts sind verschiedene Belege. Dasselbe gilt für ein Museumsverzeichnis: Ein Verweis auf einen Gegenstand ersetzt seine Untersuchung nicht.
Eine berechnete Reihenfolge ist keine Fachprüfung
Die Struktur eines Linknetzes kann Aufmerksamkeit und Beziehungen sichtbar machen. Sie entscheidet aber nicht von selbst, ob eine naturwissenschaftliche Behauptung stimmt. Die Formulierung eines objektiven Maßes im historischen Text wird deshalb nicht als Nachweis objektiver Wahrheit übernommen. Ranking und seine Aussagegrenze
Der Beitrag bespricht selbst Probleme wie manipulierte Inhalte, Abruffehler und begrenzte Abdeckung. Eine vollständige Nutzerevaluation gehört nach eigener Aussage nicht zum Gegenstand des Aufsatzes. Einzelne demonstrierte Suchbeispiele und positive Bewertungen der Autoren ersetzen keine unabhängige allgemeine Vergleichsstudie zur Qualität sämtlicher Antworten.
Drei Fragen an jede Trefferliste
Für den Blick auf eine Trefferliste helfen drei getrennte Fragen: Was wurde überhaupt erfasst? Nach welchen Merkmalen wurden die Kandidaten geordnet? Welche inhaltliche Behauptung ist am jeweiligen Ziel tatsächlich belegt? Der Prototyp zeigt Verfahren für die ersten beiden Aufgaben, ohne die dritte vollständig zu übernehmen. Abdeckung und Auswahl
Brin und Page heben zudem die Mitentwicklung durch Scott Hassan und Alan Steremberg hervor. Das Suchsystem ist ein Zusammenspiel mehrerer Arbeiten. Die letzte Station wechselt von Auffindbarkeit zur Vertraulichkeit: Ein geheimer gemeinsamer Wert und die zuverlässige Identität des Kommunikationspartners verlangen wieder andere Nachweise.
Grenzen des Wissens
Was offen bleibt
Der gesamte Text der 20-seitigen historischen Langfassung wurde gelesen, keine Abbildung visuell geprüft und kein damaliges Programm ausgeführt. Die dargestellte Architektur beschreibt einen Forschungsprototyp, nicht die heutige Google-Suche. Keine unkritische Übernahme der inkonsistenten Formel oder der Selbsteinschätzung überlegener Suchqualität.
Begriffe verstehen
Crawler
Programm, das erreichbare Dokumente für den vorgesehenen Suchbestand abruft und weiteren Zugängen folgen kann.
← Zur TextstelleInvertierter Index
Datenordnung, die von einem Wort zu den Dokumenten führt, in denen es verzeichnet ist.
← Zur TextstelleRanking
Berechnete Anordnung möglicher Treffer anhand bestimmter Merkmale und Regeln.
Linktext
Sichtbarer Text eines Verweises, der im beschriebenen System zusätzliche Information über dessen Ziel liefern kann.
Quellen und Nachweise
Die Quellen sind den Aussagen im Text zugeordnet. Originalstudien, Sammlungstexte und eigene Einordnung erfüllen unterschiedliche Aufgaben. Einige Fachtexte sind beim Verlag nur teilweise frei zugänglich.
- Textindex und gewichtete Webverweise
Sergey Brin und Lawrence Page: The Anatomy of a Large-Scale Hypertextual Web Search Engine. 1998; historische Langfassung.
Forschungsprototyp statt heutiger Google-Suche. Crawlen, Index und Ranking getrennt; gewichtete Links keine Wahrheit. Inkonsistente Formeln nicht reproduziert, Selbsteinschätzung keine unabhängige Evaluation. Hassan und Steremberg als Mitentwickler berücksichtigt.
← Zur Textstelle 1: Eine Anfrage liest nicht das ganze Web neu← Zur Textstelle 2: Vom Wort zur Liste der Dokumente← Zur Textstelle 3: Verweise werden nicht nur gezählt← Zur Textstelle 4: Was andere über ein Ziel schreiben← Zur Textstelle 5: Eine berechnete Reihenfolge ist keine Fachprüfung← Zur Textstelle 6: Drei Fragen an jede Trefferliste
Redaktion: Benjamin Metzig. Text und Quellen am 8. September 2026 geprüft. Generative KI diente als Werkzeug für Text und Bild.
Hinweis oder Korrektur an die RedaktionZusammenhänge entdecken
Exponat · Tim Berners-Lees Vorschlag und das frühe World Wide Web
Dokumente verbinden, ohne alles neu zu sortieren
Wie helfen Verweise, Wissen über unterschiedliche Dokumente und Rechner hinweg auffindbar zu halten?
Exponat erkunden ↗
Exponat · Logic Theorist: formale Regeln und heuristische Auswahl
Einen Beweisweg gezielt suchen
Wie kann ein Programm unter vielen zulässigen Schritten einen Beweis finden, ohne sämtliche möglichen Wege vollständig zu durchlaufen?
Exponat erkunden ↗