
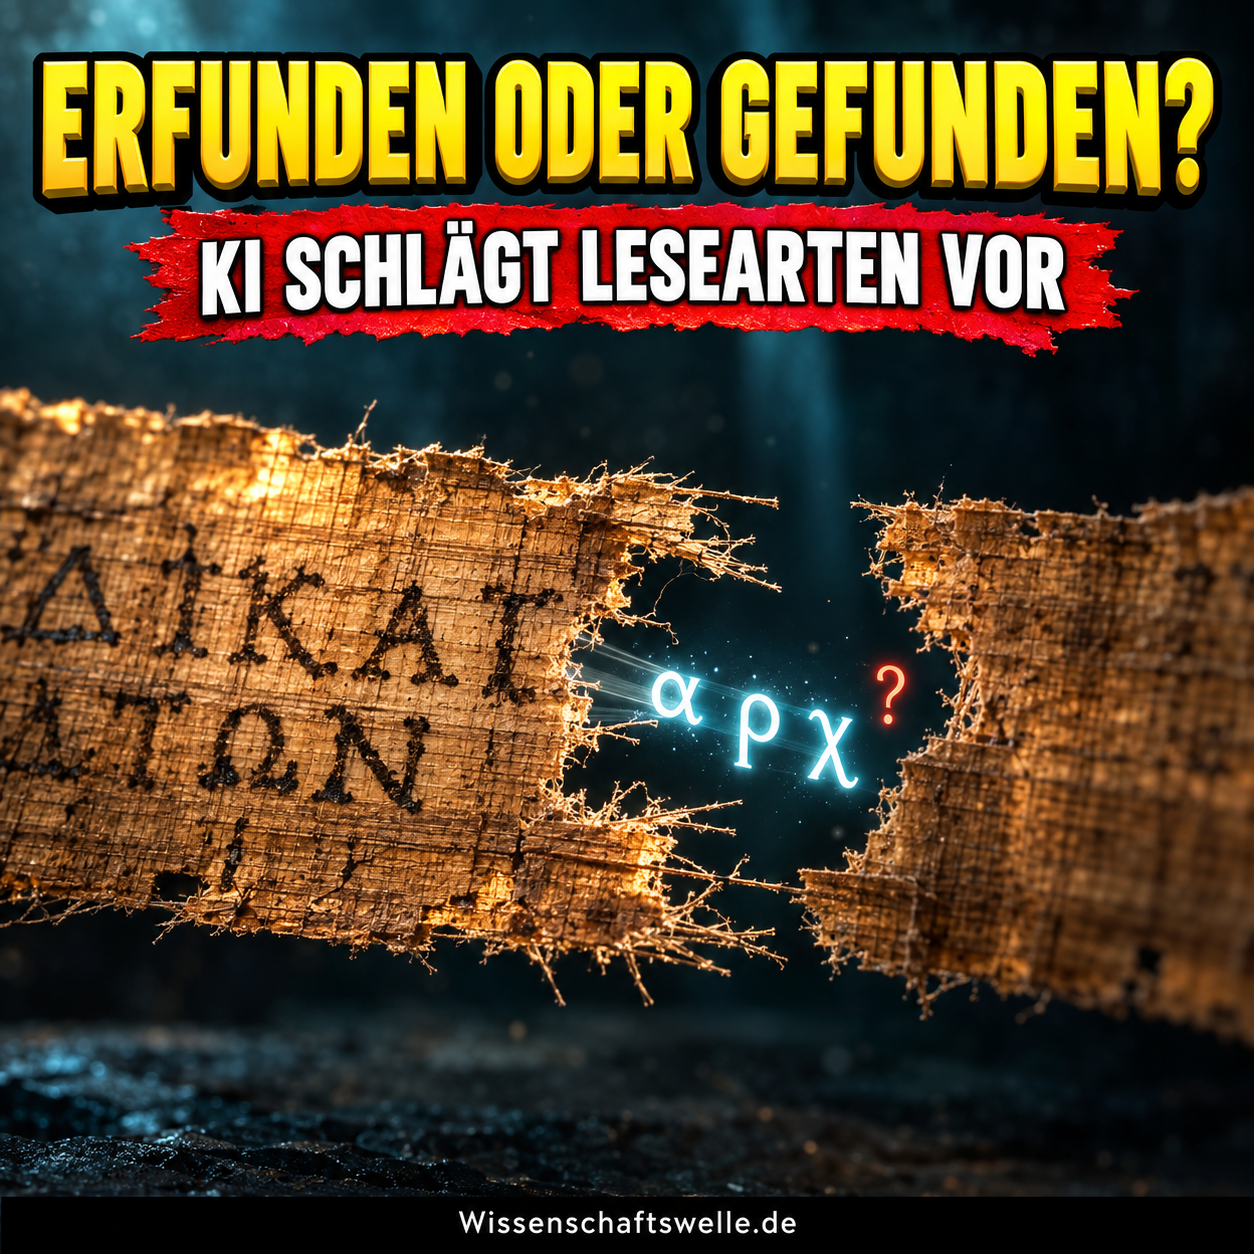
Ein Loch im Papyrus ist keine leere Stelle im modernen Sinn. Rund um die Lücke stehen Buchstaben ohne sichere Wortgrenzen, Akzente fehlen, der Satzbau lässt mehrere Wege offen. Im August 2026 haben Eric Cullhed und Albin Thörn Cleland dafür ein neues Sprachmodell vorgestellt: Stoicheia soll mögliche Lesarten beschädigter altgriechischer Texte genauer eingrenzen. Das ist ein beachtlicher Fortschritt. Aber es ist keine Zeitmaschine. Dieser Artikel zeigt, was das Modell tatsächlich kann – und warum die wahrscheinlichste Ergänzung noch lange nicht der verlorene Originalsatz ist.
Die kurze Antwort
Stoicheia berechnet aus altgriechischen Textmustern plausible Buchstaben, Wortgrenzen, Akzente und Satzzeichen für beschädigte Stellen. Im Preprint schlägt es frühere Systeme in kontrollierten Tests, beweist damit aber keinen verlorenen Originalwortlaut.
- Das Modell arbeitet auf fünf getrennten Zeichenebenen und kann deshalb auch unsegmentierten oder unakzentuierten Text bearbeiten.
- Auf einem gemeinsamen Testsplit berichtet der Preprint 15,5 Prozent Zeichenfehlerrate und 74,5 Prozent Top-1-Genauigkeit.
- Echte Schäden, seltene Formulierungen und materieller Kontext bleiben außerhalb vieler Benchmarks; Fachleute müssen jede Lesart prüfen.
KI kann den Suchraum verkleinern – aus Wahrscheinlichkeit wird erst durch unabhängige Evidenz eine belastbare Lesart.
Kernpunkte
- Stoicheia verarbeitet Altgriechisch auf Zeichenebene und trennt Buchstaben, Wortgrenzen, Diakritika, Großschreibung und Interpunktion in fünf bearbeitbare Ebenen.
- Im eigenen Preprint schneidet das Modell auf einem gemeinsamen Testdatensatz besser ab als frühere Systeme. Der Text ist jedoch noch nicht peer-reviewt.
- Die meisten Tests verstecken bekannte Zeichen künstlich. Echte Schäden bringen zusätzliche Probleme mit: unsichere Lückenlänge, Materialverlust, Schreibfehler und fehlenden historischen Kontext.
- Das Modell liefert Hypothesen, keine wiedergefundenen Originale. Eine belastbare Lesart entsteht erst durch den Abgleich mit Papyrus, Sprache, Gattung, Datierung und Paralleltexten.
Eine Textlücke ist kein Kreuzworträtsel
Wer bei einem beschädigten Satz nur ein paar fehlende Buchstaben ergänzt, unterschätzt die Aufgabe. Antike griechische Texte können ohne moderne Wortabstände geschrieben sein. Auf Papyri kommen individuelle Schreibweisen, Abkürzungen, Fehler und spätere Korrekturen hinzu. Bei Dichtung entscheidet manchmal sogar die Länge einer Silbe darüber, ob ein Vers funktioniert.
Die Philologie arbeitet deshalb nicht mit einem einzigen Hinweis. Sie prüft Buchstabenreste, Fasern, Zeilenlänge, Grammatik, Wortgebrauch, Versmaß und ähnliche Formulierungen in anderen Texten. Digitale Sammlungen wie Papyri.info bündeln dafür Transkriptionen, Übersetzungen, Kommentare und Metadaten in einer versionierten wissenschaftlichen Umgebung. Ein Modell kann in diesen großen Textmengen Muster finden, die ein Mensch nicht in derselben Geschwindigkeit durchsucht. Es sieht aber weder automatisch die beschädigte Faser noch kennt es die Fundgeschichte eines Fragments.
Genau hier liegt der Unterschied zur optischen Erkennung. Der bestehende Wissenschaftswelle-Beitrag zur Handschriftenerkennung mit KI erklärt, wie sichtbare Zeichen aus Scans transkribiert werden. Stoicheia setzt an einer anderen Stelle an: Dort, wo Zeichen nicht mehr sichtbar sind, berechnet es sprachlich passende Ergänzungen.
Fünf Ebenen statt eines fertigen Wortes
Der Stoicheia-Preprint beschreibt einen 405-Millionen-Parameter-Encoder für Altgriechisch. „Zeichenbasiert“ bedeutet: Das Modell behandelt den Text nicht primär als Folge bereits fertiger Wörter oder Wortstücke. Es zerlegt ihn in fünf aufeinander ausgerichtete Ebenen: Buchstaben, Wort- und Satzgrenzen, Diakritika, Großschreibung und Interpunktion.
Das ist für antike Texte praktisch. Eine Lücke kann nicht nur Buchstaben verschlucken. Auch die Entscheidung, wo ein Wort endet, welche Akzente ergänzt werden und wie ein Satz gegliedert wird, beeinflusst die Lesart. Stoicheia kann diese Ebenen einzeln maskieren und wiederherstellen. Der gleiche Modellkern soll außerdem grammatische Formen bestimmen, Abhängigkeiten zwischen Wörtern analysieren sowie Vokallängen und Versmaß erschließen.
Der Name passt: stoicheia kann im Griechischen Elemente oder Buchstaben bezeichnen. Technisch arbeitet das System als maskiertes Diffusionsmodell. Vereinfacht gesagt beginnt es mit gestörten oder verdeckten Zeichen und lernt, schrittweise eine wahrscheinlichere Textgestalt herzustellen. Das ist keine freie Fortsetzung wie bei einem Chatbot. Es ist eine spezialisierte Rekonstruktionsaufgabe mit kontrollierten Eingaben und messbarem Ziel.
Wie Stoicheia eine Lücke bearbeitet
Zeichen werden getrennt beschrieben
Buchstaben, Grenzen, Diakritika, Großschreibung und Interpunktion liegen als fünf ausgerichtete Ebenen vor, statt als bereits fertige Wörter vorausgesetzt zu werden.
Unbekanntes wird gezielt maskiert
Eine oder mehrere Ebenen können an beschädigten Stellen auf unbekannt gesetzt werden; auch eine unsichere Lückenlänge lässt sich als Kandidatenraum behandeln.
Das Modell entrauscht schrittweise
Der Diffusionsansatz lernt, aus gestörten Zeichenfolgen eine wahrscheinlichere Textgestalt zu rekonstruieren und mehrere Ebenen miteinander abzustimmen.
Philologie prüft die Vorschläge
Material, Grammatik, Gattung, Versmaß, Datierung und Paralleltexte entscheiden, ob eine vorgeschlagene Ergänzung historisch tragfähig ist.
Die besseren Zahlen sind stark – aber vorläufig
Die Autoren trainierten das Modell nach eigenen Angaben auf einem offenen, fest versionierten Korpus mit rund 380 Millionen Wörtern. Sie veröffentlichten elf Checkpoints. Zehn davon rotieren getrennte Trainings- und Testbereiche literarischer Texte; ein weiterer soll keinerlei dokumentarische Papyri oder Inschriften im Vortraining gesehen haben. Diese Trennung soll das heikle Problem mindern, dass ein Modell eine Testpassage womöglich schon aus seinen Trainingsdaten kennt.
Auf dem eingefrorenen Testsplit des älteren Systems Ithaca berichtet der Preprint eine Zeichenfehlerrate von 15,5 Prozent. Für Ithaca werden 24,6 Prozent, für einen griechischen Nachfolger aus dem Aeneas-Rahmen 23,5 Prozent angegeben. Die Top-1-Trefferrate – also wie oft der erste Vorschlag genau der verdeckten Zeichenfolge entsprach – steigt laut Autoren von 63 beziehungsweise 64 Prozent auf 74,5 Prozent.
Diese Werte sind ein überzeugender Forschungsanlass, aber noch kein endgültiges Urteil. Der Stoicheia-Text wurde am 7. August 2026 als Preprint eingereicht und hat zum Redaktionszeitpunkt kein Peer Review durchlaufen. Positiv ist, dass Code und Modelle öffentlich dokumentiert sind. Andere Fachleute können die Auswertung also genauer prüfen und auf neuen Beständen wiederholen.
Drei Modellgenerationen im Vergleich
| Kriterium | Schwerpunkt | Stärke | Wichtige Grenze |
|---|---|---|---|
| Ithaca (2022) | Griechische Inschriften restaurieren, datieren und verorten | Peer-reviewte Mensch-Modell-Studie; Zusammenarbeit erreichte 72 Prozent Rekonstruktionsgenauigkeit | Kontrollierte künstliche Schäden und begrenzte Zahl fachlicher Testpersonen |
| Aeneas (2025) | Lateinische Inschriften mit Text, Bild und historischen Parallelen kontextualisieren | Lücken unbekannter Länge und explizite Suche nach nützlichen Vergleichsinschriften | Andere Sprache und anderer Datensatz; nicht direkt mit jeder griechischen Aufgabe gleichzusetzen |
| Stoicheia (2026) | Altgriechische Zeichen, Segmentierung, Grammatik und Versmaß in einem Modell | Preprint berichtet 15,5 Prozent Zeichenfehlerrate und de-kontaminierte Checkpoints | Noch nicht peer-reviewt; künstliche Masken bilden reale Schäden nur teilweise ab |
Der schwierigste Test ist die echte Lücke
Für eine messbare Auswertung braucht man eine bekannte richtige Antwort. Forschende nehmen deshalb häufig einen intakten Text und verdecken darin künstlich mehrere Zeichen. Anschließend lässt sich exakt zählen, wie viele Buchstaben das Modell richtig rekonstruiert. Das ist sauber – und bildet doch nicht die gesamte Wirklichkeit ab.
Bei einem echten Papyrus ist womöglich unklar, wie viele Zeichen überhaupt fehlen. Eine Schreiberin kann eine ungewöhnliche Form verwendet haben. Der Text kann aus einer seltenen Gattung stammen, eine lokale Schreibtradition spiegeln oder selbst fehlerhaft sein. Ein Brandloch, ein Faserriss oder verwischte Tinte liefern materielle Hinweise, die in einer reinen Transkription verschwinden. Stoicheia adressiert einen Teil davon, etwa unsichere Lückenlängen und unsegmentierten Text. Es löst nicht alle Probleme der Überlieferung.
Die Gefahr ist gerade deshalb groß, weil ein gutes Modell überzeugende Vorschläge erzeugt. Eine grammatisch perfekte Ergänzung kann historisch falsch sein. Vielleicht wählt sie die häufigste Formel, obwohl das Fragment eine seltene Abweichung bewahrt. Vielleicht glättet sie genau jene ungewöhnliche Wendung, die literarisch interessant wäre. In der Textgenetik gilt schon bei modernen Manuskripten: Varianten sind nicht bloß Störungen, sondern Spuren einer Entstehungs- und Überlieferungsgeschichte.
Ithaca und Aeneas zeigen, warum Menschen im Verfahren bleiben
Stoicheia steht nicht am Anfang dieser Entwicklung. Das peer-reviewte System Ithaca wurde 2022 für beschädigte griechische Inschriften vorgestellt. Es sollte fehlende Zeichen ergänzen sowie Ort und Zeit eines Textes eingrenzen. In einer kontrollierten Studie erreichten Fachleute allein bei der Rekonstruktion 25 Prozent Genauigkeit, Ithaca allein 62 Prozent und Fachleute mit Ithaca-Hilfe 72 Prozent. Der wichtige Befund war nicht „Maschine schlägt Mensch“, sondern: Die Kombination war stärker als beide einzeln.
2025 folgte Aeneas für lateinische Inschriften. Das System sucht historische Paralleltexte, verarbeitet zusätzlich Bilder und kann Lücken unbekannter Länge bearbeiten. In der Studie arbeiteten 23 Personen mit epigrafischer Expertise an einem mehrstufigen Vergleich. Auch hier war der Wert des Modells nicht nur ein fertiger Lösungsvorschlag. Es konnte relevante Parallelen sichtbar machen, an denen Fachleute ihre Entscheidung prüfen.
Eine 2026 erschienene Studie zu feinabgestimmten Sprachmodellen berichtete bereits starke Ergebnisse für griechische Papyri und Inschriften. Stoicheia verschärft nun die Frage nach Trainingsnähe und kontrollierten Vergleichsgruppen. Das Feld lernt also nicht nur, bessere Zahlen zu produzieren. Es lernt, misstrauischer gegenüber seinen eigenen Zahlen zu werden.
Was trägt eine Rekonstruktion – und was nicht?
Gemeinsamer Benchmark
Stoicheia wird auf eingefrorenen Stichproben des Ithaca-Testsets mit früheren Systemen verglichen.
- Aussagekraft
- Gleiche Beispiele und strenge Zeichenwertung machen den technischen Fortschritt besser prüfbar.
- Grenze
- Ein Benchmark mit bekannter Zielantwort ist keine unbekannte reale Lücke mit beschädigtem Material.
De-Kontamination
Rotierende Checkpoints sollen für jede literarische Passage mindestens ein Modell bereitstellen, das sie nicht im Vortraining gesehen hat.
- Aussagekraft
- Die Konstruktion adressiert das zentrale Risiko, dass ein Modell Testtexte lediglich erinnert.
- Grenze
- Korpusabgrenzung und Ähnlichkeitssuche können nicht jede indirekte Trainingsnähe vollständig ausschließen.
Materieller Kontext
Papyrusfasern, Tintenreste, Zeilenkanten, Fundort und editorische Vorgeschichte liefern unabhängige Hinweise.
- Aussagekraft
- Mehrere Evidenzarten können eine sprachlich plausible Ergänzung stützen oder widerlegen.
- Grenze
- Diese Hinweise sind in reinen Textmodellen oft gar nicht oder nur indirekt enthalten.
Peer Review und Replikation
Preprint, Code und Checkpoints sind öffentlich; unabhängige Tests und fachliche Begutachtung stehen noch aus.
- Aussagekraft
- Offene Artefakte ermöglichen Nachrechnen, Fehleranalyse und Tests auf neuen Textbeständen.
- Grenze
- Bis dahin bleiben die neuen Spitzenwerte Ergebnisse der Autoren und kein endgültiger Feldstandard.
Was ein Modell nicht aus der Lücke lesen kann
Ein Sprachmodell bewertet Muster im Text. Es kann nicht aus sich heraus entscheiden, ob eine Ergänzung zur Tintenfarbe, zur Hand des Schreibers, zum Fundort oder zu einer beschädigten Zeilenkante passt. Es kennt auch nicht automatisch die editorische Geschichte: Wurde eine Lesart früher verworfen? Ist das vermeintliche Vergleichswort in einer neuen Edition anders aufgelöst? Gehört das Fragment überhaupt zu dem Werk, dem es zugeschrieben wurde?
Die große Fachübersicht zu maschinellem Lernen für alte Sprachen beschreibt offene, verknüpfte und sauber kodierte Daten als Voraussetzung des Fortschritts. Das ist mehr als eine technische Fußnote. Jede Modellleistung hängt davon ab, welche Texte digital vorliegen, wie sie ediert wurden und welche Traditionen im Korpus überrepräsentiert sind.
Literatur macht die Sache zusätzlich unbequem. Ein Autor kann absichtlich gegen gewöhnliche Syntax, Rhythmus oder Wortwahl verstoßen. Genau das, was ein Wahrscheinlichkeitsmodell als unwahrscheinlich behandelt, kann die Pointe eines Verses sein. Ein Modell darf deshalb den Möglichkeitsraum ordnen. Es darf die ungewöhnliche Lesart nicht allein deshalb wegfiltern, weil sie ungewöhnlich ist.
So sollte man eine KI-Rekonstruktion lesen
Vier Fragen schützen vor falscher Gewissheit:
- Was war die Eingabe? Eine reine Transkription, ein Bild oder beides?
- War die richtige Antwort bekannt? Ein künstlich maskierter Test ist etwas anderes als eine reale, ungeklärte Lücke.
- Kannte das Modell den Text möglicherweise schon? De-kontaminierte Checkpoints sind hilfreich, aber auch ihre Prüfung braucht Transparenz.
- Welche unabhängigen Hinweise passen zur Ergänzung? Material, Grammatik, Versmaß, Parallelstellen, Datierung und Fundkontext müssen zusammenpassen.
Das ist keine Abwertung der Technik. Im Gegenteil: Ein Werkzeug wird wissenschaftlich stärker, wenn klar ist, welche Entscheidung es vorbereitet und welche es nicht übernehmen kann. Auch bei den Graffiti von Pompeji entsteht historische Bedeutung erst aus Schrift, Ort und sozialem Kontext gemeinsam.
Die Lücke bleibt sichtbar – und das ist gut so
Stoicheia kann die Arbeit an altgriechischen Texten beschleunigen. Es kann aus Tausenden möglichen Buchstabenfolgen eine überschaubare Liste machen, Wortgrenzen neu prüfen und sogar das Versmaß als zusätzliche Spur nutzen. Wenn die berichteten Vorteile unabhängige Tests überstehen, bekommt die Philologie ein bemerkenswert vielseitiges Werkzeug.
Der wichtigste Fortschritt ist trotzdem nicht, dass eine KI die Lücke „füllt“. Wissenschaftlich wertvoll wird sie, wenn sie mehrere begründete Lesarten anbietet, Unsicherheit sichtbar lässt und Fachleuten bessere Vergleiche ermöglicht. Ein verlorener Satz kehrt nicht zurück, nur weil ein Modell ihn flüssig formuliert. Aber die Suche nach ihm kann präziser werden. Gerade darin liegt die Stärke: Die Lücke verschwindet nicht – sie wird endlich besser befragbar.
Schreibe einen Kommentar