Du hast den Unfall selbst gesehen. Ein rotes Auto, eine Kreuzung, ein Mensch auf der Fahrbahn. Am nächsten Tag liest du eine Zusammenfassung. Darin steht ein anderes Verkehrsschild als in der Szene. Wenn dich anschließend jemand fragt, welches Schild dort war: Antwortest du aus dem Bild im Kopf – oder aus dem Text, der gerade viel frischer ist?
Eine neue Studie zeigt, dass irreführende KI-Zusammenfassungen die spätere Wiedererkennung eines gesehenen Details beeinflussen können. Der bemerkenswerte Punkt ist dabei die Rolle des Menschen: Wer einen KI-Text anhand seiner Erinnerung kontrollieren soll, kann durch das Lesen selbst beeinflusst werden. Das Experiment belegt diesen begrenzten Effekt. Es zeigt keine digitale Gehirnwäsche und keine Löschung ganzer Lebensereignisse.
Ein Schild, zwei Versionen
Für die Arbeit von Mattea Sim, Yael Eiger und Yoshi Kohno sahen Erwachsene ein 25 Sekunden langes animiertes Unfallvideo. Nach 24 bis 48 Stunden lasen sie eine Zusammenfassung. Die Forschenden variierten gezielt, ob der Text das richtige oder das falsche Schild nannte: Stoppschild oder „Vorfahrt gewähren“. Außerdem wurde der Text wahlweise einer KI oder einem menschlichen Transkribenten zugeschrieben. Tatsächlich beruhte er in allen Gruppen auf KI-Ausgaben, die für den kontrollierten Vergleich bearbeitet und zusammengesetzt wurden. Ausgewertet wurden 328 Personen.
Der entscheidende Unterschied war also absichtlich eingebaut. Hier wurde nicht bei jedem Teilnehmer ein beliebiger neuer KI-Fehler erzeugt und dessen Wirkung abgewartet. Die Versuchsanordnung isoliert eine engere Frage: Was richtet ein solcher falscher Hinweis bei der späteren Wiedererkennung an?
Die Ergebnisübersicht der Georgetown University nennt einen deutlichen Abstand: Nach einer zum Video passenden Zusammenfassung erkannten 83,6 Prozent das Schild richtig. Nach einer irreführenden waren es 44,8 Prozent. Gefragt wurde nach dem ursprünglich gesehenen Video, mit zwei Antwortmöglichkeiten. Der Hinweis auf eine KI als vermeintliche Quelle bot in diesem Versuch keinen statistisch nachweisbaren Schutz. Daraus folgt nicht, dass jede Warnung wirkungslos wäre oder Menschen und KI unter allen Bedingungen gleich wirken.
Ein falsches Schild in einer Zusammenfassung erscheint zunächst wie ein redaktioneller Fehler. Sobald der Text aber die spätere Antwort eines Augenzeugen beeinflusst, betrifft das Problem auch die vermeintlich unabhängige Kontrolle. Die falsche Angabe kann in die Prüfung zurückkehren, mit der sie eigentlich entdeckt werden sollte.
Vertraut ist nicht dasselbe wie selbst gesehen
Um das zu verstehen, muss man zwei Fragen auseinanderhalten: „Kommt mir dieses Detail bekannt vor?“ und „Woher kenne ich es?“ Ein Schild kann vertraut sein, weil es im Video vorkam. Es kann aber auch vertraut sein, weil gerade ein Text davon erzählte.
Die Übersicht von Karen Mitchell und Marcia Johnson zum Quellenmonitoring beschreibt, wie wir die Herkunft von Erinnerungsinhalten erschließen. Dabei helfen unter anderem Wahrnehmungsdetails, räumlicher und zeitlicher Zusammenhang, Gedanken und ein Gefühl von Vertrautheit. Diese Zuordnung ist eine Leistung des Erinnerns. Sie gelingt oft, kann aber scheitern. Eine gut verfügbare Information trägt nicht automatisch eine verlässlich erkennbare Herkunft mit sich.
Das erklärt, weshalb eine bloße Aufforderung zur Selbstprüfung schwierig sein kann. „Denk noch einmal genau nach“ liefert keine zusätzliche Aufnahme des Ereignisses. Man muss weiterhin beurteilen, welche verfügbaren Details aus welcher Begegnung stammen. Die neue Studie hat allerdings keine Hirnaktivität gemessen und entscheidet nicht abschließend, welcher einzelne Gedächtnismechanismus den beobachteten Antworten zugrunde liegt.
Der größere Zusammenhang steht in unserem Beitrag über Erinnerung als Rekonstruktion. Die neue Frage geht darüber hinaus: Was geschieht, wenn ein System, dessen Ausgabe wir überprüfen wollen, vorher einen Teil unseres Prüfmaßstabs beeinflusst?
Quer durch das Archiv
Zufällig entdeckt
Drei Beiträge aus dem ganzen Magazin. Wohin führt deine Neugier?
Wirtschaft
Zollpolitik – Schutzschild oder Stolperfalle der Weltwirtschaft?

Technik
E-Scooter Faktencheck: Warum wir die Roller hassen – und trotzdem brauchen
Bildung
Handschrift oder Tastatur? Warum das Lernziel entscheidet
Neue Auswahl alle 12 Sekunden.
Eine falsche Antwort ist noch keine gelöschte Spur
Diese Unterscheidung beschäftigt die Forschung seit Jahrzehnten. Bereits Michael McCloskey und Maria Zaragoza kritisierten 1985, dass schlechtere Testleistungen nach irreführender Information nicht automatisch eine beschädigte ursprüngliche Erinnerung belegen. Ein Test kann auch davon abhängen, welche Antwort jemand auswählt, welcher Quelle er vertraut oder welche Information gerade leichter verfügbar ist. Mit einer veränderten Testanordnung fanden sie in sechs Experimenten keinen entsprechenden Verlust der ursprünglichen Information.
Das war nicht das Ende der Debatte. Elizabeth Loftus, Jonathan Schooler und Willem Wagenaar widersprachen noch im selben Jahr: Ein veränderter Test könne für bestimmte Effekte zu unempfindlich sein. Sie verwiesen unter anderem auf Erinnerungsangaben, in denen ursprüngliche und spätere Informationen verschmelzen. Diese historische Kontroverse macht die aktuelle Frage genauer. Man muss den beobachteten Fehler ernst nehmen, ohne aus der Antwort direkt den Zustand einer einzelnen gespeicherten Gedächtnisspur abzulesen.
Für das Stoppschild heißt das: Die Wiedererkennungsleistung unterscheidet sich deutlich. Ob eine ursprüngliche Information verdrängt wird, mit einer anderen konkurriert oder unter diesen Testbedingungen schlechter als Quelle genutzt wird, ist eine weitergehende Erklärung. Im Alltag kann schon die falsche Aussage folgenreich sein, selbst wenn ein anderer Test noch Zugang zum richtigen Detail ermöglichen würde.
Die nüchterne Formulierung ist deshalb stärker als „Die KI hat das Gehirn überschrieben“. Sie sagt genau, was überprüft wurde, und lässt Raum für Forschung darüber, warum es geschah. Unsicherheit über den Mechanismus macht den Befund nicht harmlos; sie begrenzt nur die Geschichte, die man darüber erzählen darf.
Der Fehler muss nicht im Text bleiben
Die Forschungsrichtung umfasst auch Bilder. In einer 2025 veröffentlichten Studie aus dem Umfeld des MIT Media Lab betrachteten 200 Menschen zunächst Originalbilder. Später sahen verschiedene Gruppen unveränderte oder mit KI bearbeitete Bilder beziehungsweise daraus erzeugte Videos. Die veränderten Darstellungen begünstigten falsche Erinnerungsangaben; am stärksten war der Effekt bei Videos aus bereits bearbeiteten Bildern. Das ist ein verwandter Befund, keine Wiederholung des neuen Textversuchs.
Auch ein Gespräch lässt sich untersuchen. In der IUI-Studie „Slip Through the Chat“ von 2025 lasen 180 Teilnehmende zunächst einen Artikel. Danach folgte je nach Gruppe keine weitere Intervention, eine korrekte oder irreführende Zusammenfassung oder ein Gespräch mit einem ehrlichen beziehungsweise gezielt irreführenden Chatbot. Die irreführenden Gespräche führten häufiger zu falschen Erinnerungsangaben als die irreführenden Zusammenfassungen.
Hier ging es um absichtlich manipulierte Systeme und Erinnerung an gelesene Information. Das ist kein Nachweis, dass jeder freundliche Alltagschat dieselbe Wirkung hat. Es erweitert aber die Gestaltungsfrage: Eine feste Zusammenfassung ist nur eine mögliche Form späterer Information. Ein Gespräch kann auf Antworten eingehen und falsche Angaben in eine fortlaufende Unterhaltung einbetten.
Ein Fotoalbum und ein Unfallprotokoll erfüllen sehr unterschiedliche Aufgaben. Gemeinsam ist ihnen eine mögliche Rückwirkung: Eine spätere Darstellung kann mitbestimmen, was wir vom früheren Anblick berichten. Für die Gestaltung solcher Systeme reicht deshalb die Frage „Ist der ausgegebene Inhalt richtig?“ allein nicht aus. Es kommt auch darauf an, wann jemand ihn sieht und worauf eine spätere Prüfung beruht.
Das ist eine Schlussfolgerung für die Gestaltung von Abläufen, kein im Experiment getestetes Sicherheitsverfahren. Ein plausibles Beispiel wäre, bei wichtigen Vorgängen die eigene erste Beobachtung festzuhalten und eine spätere Zusammenfassung anschließend am Originalmaterial zu prüfen. Die erste Notiz bleibt dabei ebenfalls fehlbar. Ihr Nutzen wäre, dass sich frühe Beobachtung und spätere Ergänzung noch unterscheiden lassen.
Warum ein KI-Etikett nicht jede Warnung ersetzt
Der fehlende Schutz durch das KI-Label könnte leicht als Entwarnung für Hersteller oder als Resignation beim Publikum ankommen: Kennzeichnung hilft eben nicht. Doch „Dieser Text stammt von einer KI“ beantwortet zunächst eine Herkunftsfrage. Es erklärt noch nicht, ob falsche Details vorkommen, welche das sein könnten und was für die nächste Aufgabe daraus folgt.
Die ältere Warnungsforschung gibt dafür einen wichtigen Gegenakzent. Hartmut Blank und Céline Launay werteten 2014 insgesamt 25 Studien mit 155 Effektgrößen aus. Untersucht wurden Warnungen, die nach irreführender Information und vor dem Gedächtnistest auf deren Vorhandensein aufmerksam machten. Im Mittel sank der Fehlinformationseffekt auf weniger als die Hälfte seiner Größe ohne Warnung. Die Wirkung hing auch von der Art der Warnung ab.
Das heißt nicht, dass die Hälfte aller Personen geheilt wurde oder jedes Detail wieder richtig war. Verglichen wurde die Größe eines experimentellen Effekts. Ebenso wenig wurde damit eine heutige Benutzeroberfläche für KI-Protokolle validiert. Der Befund verhindert aber den falschen Schluss, das Gedächtnis sei gegen jede bewusste Quellenprüfung machtlos.
Zeitpunkt, Inhalt und Aufgabe einer Warnung gehören zur Wirkung. Das bloße Herkunftsetikett im neuen KI-Versuch und eine ausdrückliche nachträgliche Warnung vor Fehlinformation sind unterschiedliche Eingriffe. Aus dem Ergebnis des einen lässt sich das Ergebnis des anderen nicht ableiten.
Vom Etikett zur überprüfbaren Aussage
Herkunft benennen
Eigenes Beispiel: „Dieser Text wurde mit KI erstellt.“ Der Satz sagt etwas über die Entstehung. Er benennt keinen konkreten Widerspruch und keine richtige Antwort.
Auf einen möglichen Konflikt hinweisen
Eigenes Beispiel: „Die Zusammenfassung kann Details anders darstellen als die Aufnahme.“ Das macht die Möglichkeit zweier abweichender Versionen ausdrücklich. Wie stark eine solche Formulierung schützt, ist hier nicht getestet.
Die Aussage am Original prüfen
Eigenes Beispiel: „Halte fest, welches Schild an der betreffenden Stelle der Aufnahme zu erkennen ist, und trenne diesen Befund vom Text.“ Das verlangt eine externe Gegenprüfung. Ob sie richtig ausgeführt wurde, muss ebenfalls nachvollziehbar bleiben.
Was menschliche Kontrolle braucht
Die Gedächtnisforschung beschäftigt sich lange mit der Verunreinigung von Zeugenerinnerungen. Der Bericht der US-amerikanischen National Academies zur Augenzeugenidentifikation empfiehlt unter anderem offene, nicht lenkende Fragen, die Dokumentation der ersten Sicherheitseinschätzung und eine Aufzeichnung des Identifikationsverfahrens. Er betrifft die Identifikation von Personen; er ist keine Untersuchung heutiger KI-Zusammenfassungen. Das zugrunde liegende Anliegen ist dennoch hilfreich: Die Bedingungen, unter denen eine Aussage entsteht, gehören zu ihrer Bewertung.
Für den Umgang mit KI lässt sich daraus vorsichtig ein Arbeitsprinzip ableiten: Original, Zusammenfassung und spätere Korrektur sollten unterscheidbar bleiben. Ein Satz wie „Das wurde im Video geprüft“ braucht einen anderen Nachweis als „Das kam mir beim Lesen richtig vor“. Wie man die Dateien selbst untersucht, erklärt unser Beitrag über forensische KI und digitale Beweisspuren.
Auch der neue Versuch lässt Fragen offen. Es gab keine Vergleichsgruppe ohne Zusammenfassung; deshalb lässt sich nicht sauber aufteilen, wie viel die passende Fassung beim Erinnern half und wie viel die falsche schadete. Untersucht wurde ein kurzes animiertes Ereignis, kein realer Polizeieinsatz. Der Test folgte auf das Lesen, nicht Monate später. Die Ergebnisse messen Antworten auf eine Wiedererkennungsfrage, keine vollständige Umschreibung einer Biografie.
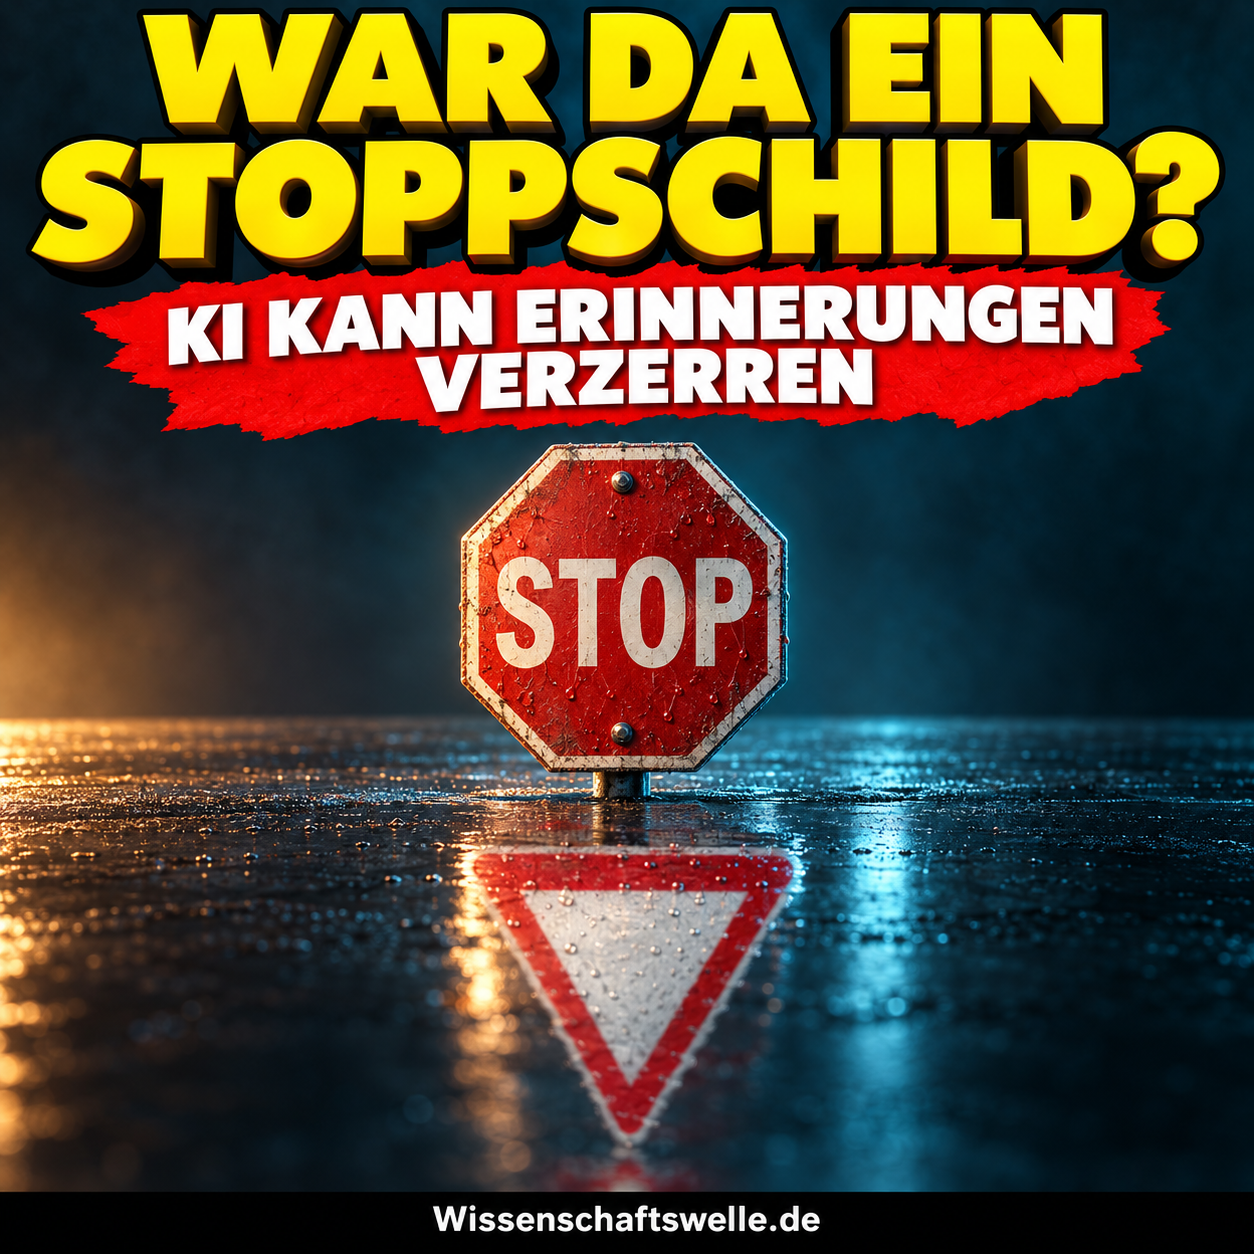
Das Cover verdichtet den Konflikt zu einer unmöglichen Spiegelung: Ein Stoppschild erscheint als Dreieck. Im Alltag ist der Widerspruch weniger sichtbar. Gerade deshalb braucht gute menschliche Kontrolle mehr als die beruhigende Vorstellung, jemand werde sich schon erinnern. Sie braucht die Möglichkeit, noch einmal nachzusehen.
Recherchestand: 1. November 2026. Vertieft um die Debatte über Gedächtnisverlust und Testantworten, Warnungsforschung sowie einen gezielt irreführenden Chatbotversuch. Die neue Stoppschild-Arbeit wurde im September 2026 veröffentlicht. Cover: symbolische KI-Illustration, keine Studienaufnahme.

Schreibe einen Kommentar